Legal AI Benchmarking: как это делать здесь? Часть 4: институциональный срез
Кто может держать независимый бенчмарк юридического ИИ, на какие деньги и где у каждой формы слабое место: обзор западного опыта и прикидки для российского рынка.
Третью часть я закончила вопросом в лоб:
Кто в состоянии поддерживать (1) качественный и обширный, (2) регулярный и (3) независимый бенчмарк?
Если судить по западному опыту, то собрать все камни бесконечности на перчатку никому не под силу. За последние полтора года у зарубежных коллег появилось много любопытных форм, и у каждой формы есть одно-два из этих трёх компонентов классного надёжного бенча, но не всё сразу. В этой части цикла посмотрим на эти формы и на слабое место каждой, а в конце я попробую прикинуть, какие из них могут прижиться у нас.
Почему вообще идёт речь об институтах? Если собрать вместе то, что уже обсуждалось в цикле, получается примерно такая картина. Хороший замер дорогой: и задачи, и оценку могут сделать только эксперты, а экспертов, готовых со всей ответственностью и пиететом к срокам делать это бесплатно, единицы. Набор задач приходится держать закрытым, иначе вендоры его быстро разберут на подгонку своих ответов. Но закрытый набор нельзя проверить снаружи, поэтому читателю лидерборда остаётся верить только в честность и неподкупность того, кто фасилитирует бенчмарк. Кроме того, замер нужно повторять, потому что продукты и модели меняются иногда на следующий день после прогона.
Получается в итоге так, что у тех, у кого есть ресурсы, почти всегда есть и конфликт интересов, а у тех, чьей незаинтересованности можно доверять, нет денег или экспертизы. Поэтому из трёх свойств хорошего бенчмарка самым дефицитным оказывается самое ценное — независимость.
Как определять независимость замера?
В первых двух частях я делила тех, кто проводит бенчмарки, на независимых фасилитаторов, вендоров и академию. Но если присмотреться к тому, как устроены конкретные проекты, независимость оказывается не неким монолитным свойством вида замерщика, а как бы спектром. Место на спектре определяют три ключевые вещи:
- Кто платит за замер?
- Кто пишет задачи и эталоны?
- Кто решает, что из результатов публиковать?
На одном краю этого спектра вендор, который сам меряет свой продукт, на другом — субъект, не зависящий от измеряемых ни деньгами, ни экспертами, ни правилами публикации. Забегая вперёд, скажу, что на этом краю в общем-то никого нет.
В обзорных публикациях описывают несколько путей, которыми бенчмарк теряет независимость:
- Захват: бенчмарк строит тот, кого он измеряет, и задачи незаметно подстраиваются под его сильные стороны. Так было у Isaacus из второй части цикла: компания построила бенчмарк поисковых моделей MLEB и сама же заняла в нём первое место.
- Размывание: чтобы измеряемые согласились участвовать, условия смягчают (дают выбирать задачи, разрешают отозваться, не публикуют отказы). Так было в первом VLAIR, где вендоры сами выбирали, в какие задачи заходить, а LexisNexis отозвался уже после того, как отчёт был написан (часть 1). Свою бизнес-модель теперь на размывании строит и Legal Benchmarks, о чём будет подробно далее.
- Лукавство: вырванную из контекста цифру используют в маркетинге.
Захват может быть и вполне открытым, и даже выглядеть несколько нагло. HAQQ, вендор юридического ИИ из региона MENA (Ближний Восток и Северная Африка), составил бенчмарк из 11 категорий задач (составление договоров разных видов, правовое исследование, разъяснение закона и т. п.) и проверил по нему 19 инструментов (моделей общего назначения и ИИ-сервисов). В каждой категории можно было набрать до 50 баллов, и HAQQ оказался первым во всех одиннадцати. Сами авторы пишут, что раз бенчмарк построили они и они же его выиграли, это конфликт интересов, и рейтинг стоит читать с поправкой на это. Там же они признают, что их критерии вознаграждают как раз то, под что заточен HAQQ: ссылки на нормы и источники, правильное определение применимого права и подсудности, учёт норм шариата, то есть работу сразу в нескольких юрисдикциях региона. Зато баллы всех 19 инструментов по всем категориям выложены на сайте, а промпты лежат в открытой библиотеке, так что результаты можно перепроверить. Интересный кейс, когда внутренний замер превращается в маркетинговый инструмент (подозреваю, что желающих перепроверить нашлось немного), и из которого можно вывести базированное наблюдение: a benchmark resembles its author :)
С вендорскими бенчами бывает и наоборот: независимость можно добавить снаружи. Открытый вендорский бенчмарк Harvey LAB стал общественным инструментом, как только его прогнали на своей инфраструктуре независимые оценщики Vals и Artificial Analysis. А проекты, которые называют себя независимыми, при ближайшем рассмотрении могут оказаться где-то в середине спектра: дальше будет несколько таких историй.
Как организовать бенчмарк?
Почти все формы, о которых пойдёт речь дальше, пришли в юридический ИИ из общего рынка оценки ИИ. Это ещё один довод в пользу вывода третьей части о том, что юристам-бенчмаркерам стоит идти за опытом к ML-специалистам, а не изобретать велосипеды. Только вместе с формой приезжают и её известные проблемы, и их полезно знать заранее.
1. Коммерческий оценщик и арены
В общем рынке оценки ИИ это одна из самых распространённых форм: компания зарабатывает на том, что меряет чужие модели и продаёт инфраструктуру оценки. Vals — как раз такая компания, и она не чисто юридическая: ведёт бенчмарки по праву, налогам и финансам, продаёт инфраструктуру оценки ИИ-лабораториям и инженерным командам и прямо оговаривает, что имеет клиентские отношения с одним или несколькими участниками своих исследований. Деньги и экспертиза у неё есть, регулярность тоже: замеры обновляются по мере выхода моделей. Независимость держится на раскрытии клиентских связей.
Отдельный тип коммерческого оценщика — арена. В общем рынке оценки ИИ самая известная арена называется, вы не поверите, Arena (а раньше называлась Chatbot Arena и LMArena). Пользователь задаёт вопрос, получает ответы двух анонимных моделей и выбирает лучший, а из миллионов таких выборов складывается рейтинг. Пользоваться ареной бесплатно, а зарабатывает она на платном продукте для ИИ-лабораторий и компаний: аналитике о том, как их модели оценивают живые пользователи, то есть во многом продаёт её тем самым лабораториям, которые ранжирует. В октябре 2026 года Arena привлекла $200 млн при оценке в $3,1 млрд (TechCrunch).
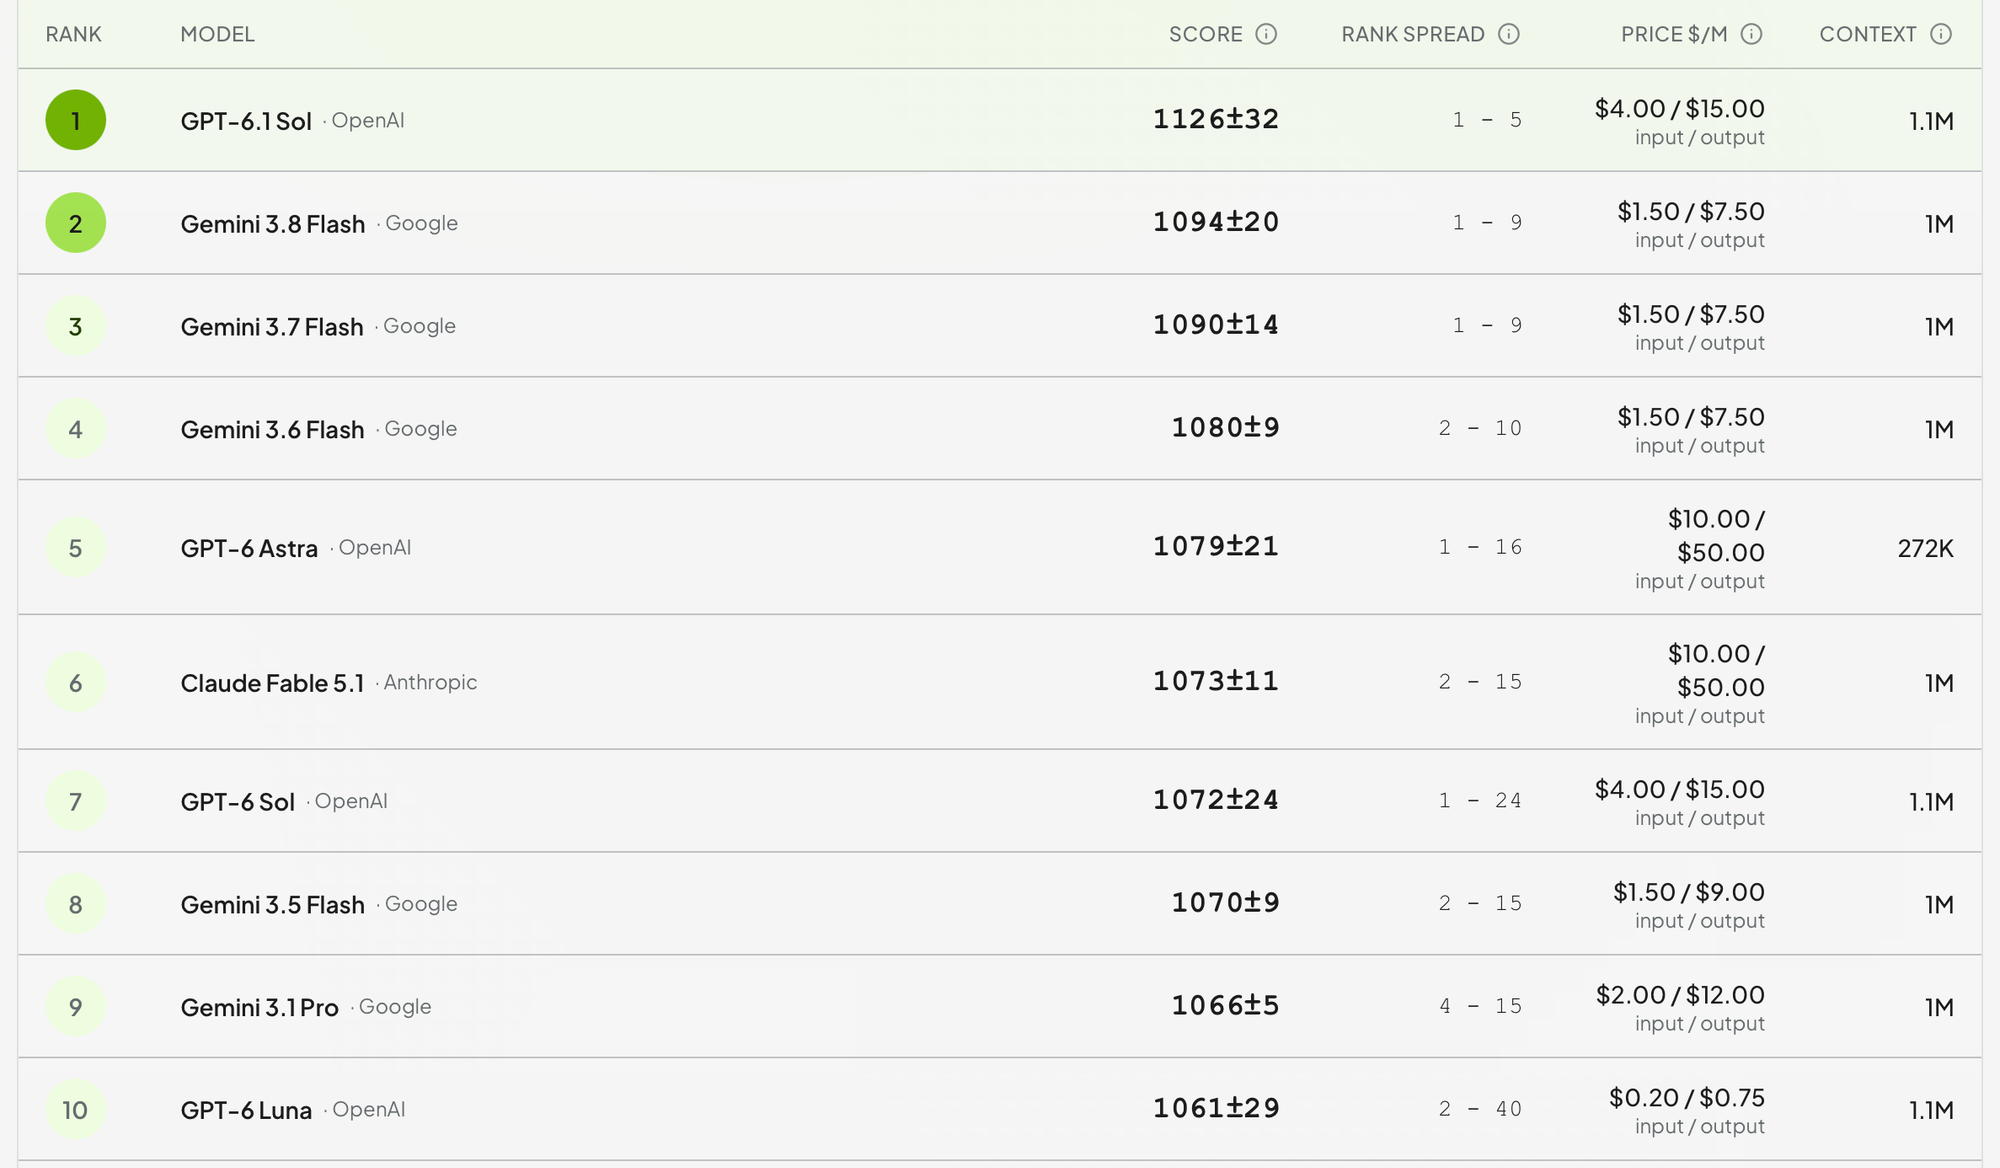
В июле 2026 года появилась юридическая арена. Её запустила американская компания Percipient, это alternative legal service provider (ALSP): она оказывает юрфирмам услуги силами своих юристов, в основном ревью документов в судебных спорах и проверку договоров. Платформа называется Certera.AI. Голосовать на ней пускают только проверенных юристов: при регистрации юристы указывают свой bar number (аналог номера в реестре адвокатов), а заявки пока проверяют вручную. Рейтинг считается по Elo (системе, которой ранжируют шахматистов) и обновляется каждый вечер, на платформе 55 моделей, промпты уходят в модель без системного промпта, а расходы на API оплачивает сама Percipient. Сам метод попарного сравнения для ранжирования надёжнее рубрик, и арена позволяет его масштабировать.
У этого проекта следующие явные ограничения:
- Основатель Percipient Чад Мейн сам признаёт в статье LawSites, что на общих аренах более красиво оформленный ответ часто собирает голоса в обход более точного. Как будут голосовать юристы, он не знает и сам формулирует вопросы, на которые ответа пока нет: что юрист оценит выше, полноту анализа или точное следование инструкции, и за кого проголосует, если один ответ технически правильнее, но инструкцию выполнил не до конца. Промпт юриста, по словам Мейна, никак не дополняют, потому что им нужно честное мнение юристов о моделях; но тогда и критерий хорошего ответа, кажется, у каждого голосующего свой.
- Рейтинг Elo строится только на попарных сравнениях и не различает виды юридической работы: голоса по семейному спору и по сделке M&A попадают в один общий рейтинг (рейтинги по областям практики Percipient обещает сделать вместе с профессором статистики).
- Чтобы набрать голосов для стабилизации рейтинга, систему досеяли публичными датасетами: вопросами по практике с ответами да/нет, проверками цитат, вопросами адвокатского экзамена. Это как раз тот класс задач, который, как мне кажется, должен остаться в истории вместе с LegalBench.
- Голоса можно продать. Каждый голос на арене — готовая пара для дообучения моделей: два ответа и выбор профессионала, какой из них лучше. Percipient примерно за полгода до запуска арены начала продавать ИИ-компаниям оценочные данные и экспертную обратную связь для обучения моделей (LawSites), а Certera в перспективе хочет предлагать платформу как сервис тестирования лабораториям, которые проверяют модели до релиза, и вендорам юридического ИИ, которые хотят сравнить свои продукты с передовыми моделями.
В общем рынке такая связка уже вызывала вопросы. В 2025 году исследователи показали, что Chatbot Arena разрешала крупным лабораториям приватно тестировать много вариантов модели и публиковать результат только лучшего: перед выходом Llama 4 Meta протестировала так 27 вариантов, а версия, которую потом выпустили публично, оказалась в рейтинге гораздо ниже той, что стояла на арене. Arena с выводами исследования спорила, но правила подачи моделей частично пересмотрела.
2. Сообщество
Legal Benchmarks из первой части был сильным образцом коммьюнити-бенчмарка с точки зрения методологии: задачи пишут юристы из своей практики, рубрика допускает несколько правильных форм ответа, судьи валидируются. За лето 2026-го проект поменял способ замера (я немного в шоке с того, насколько медленно я работаю над этим циклом...).
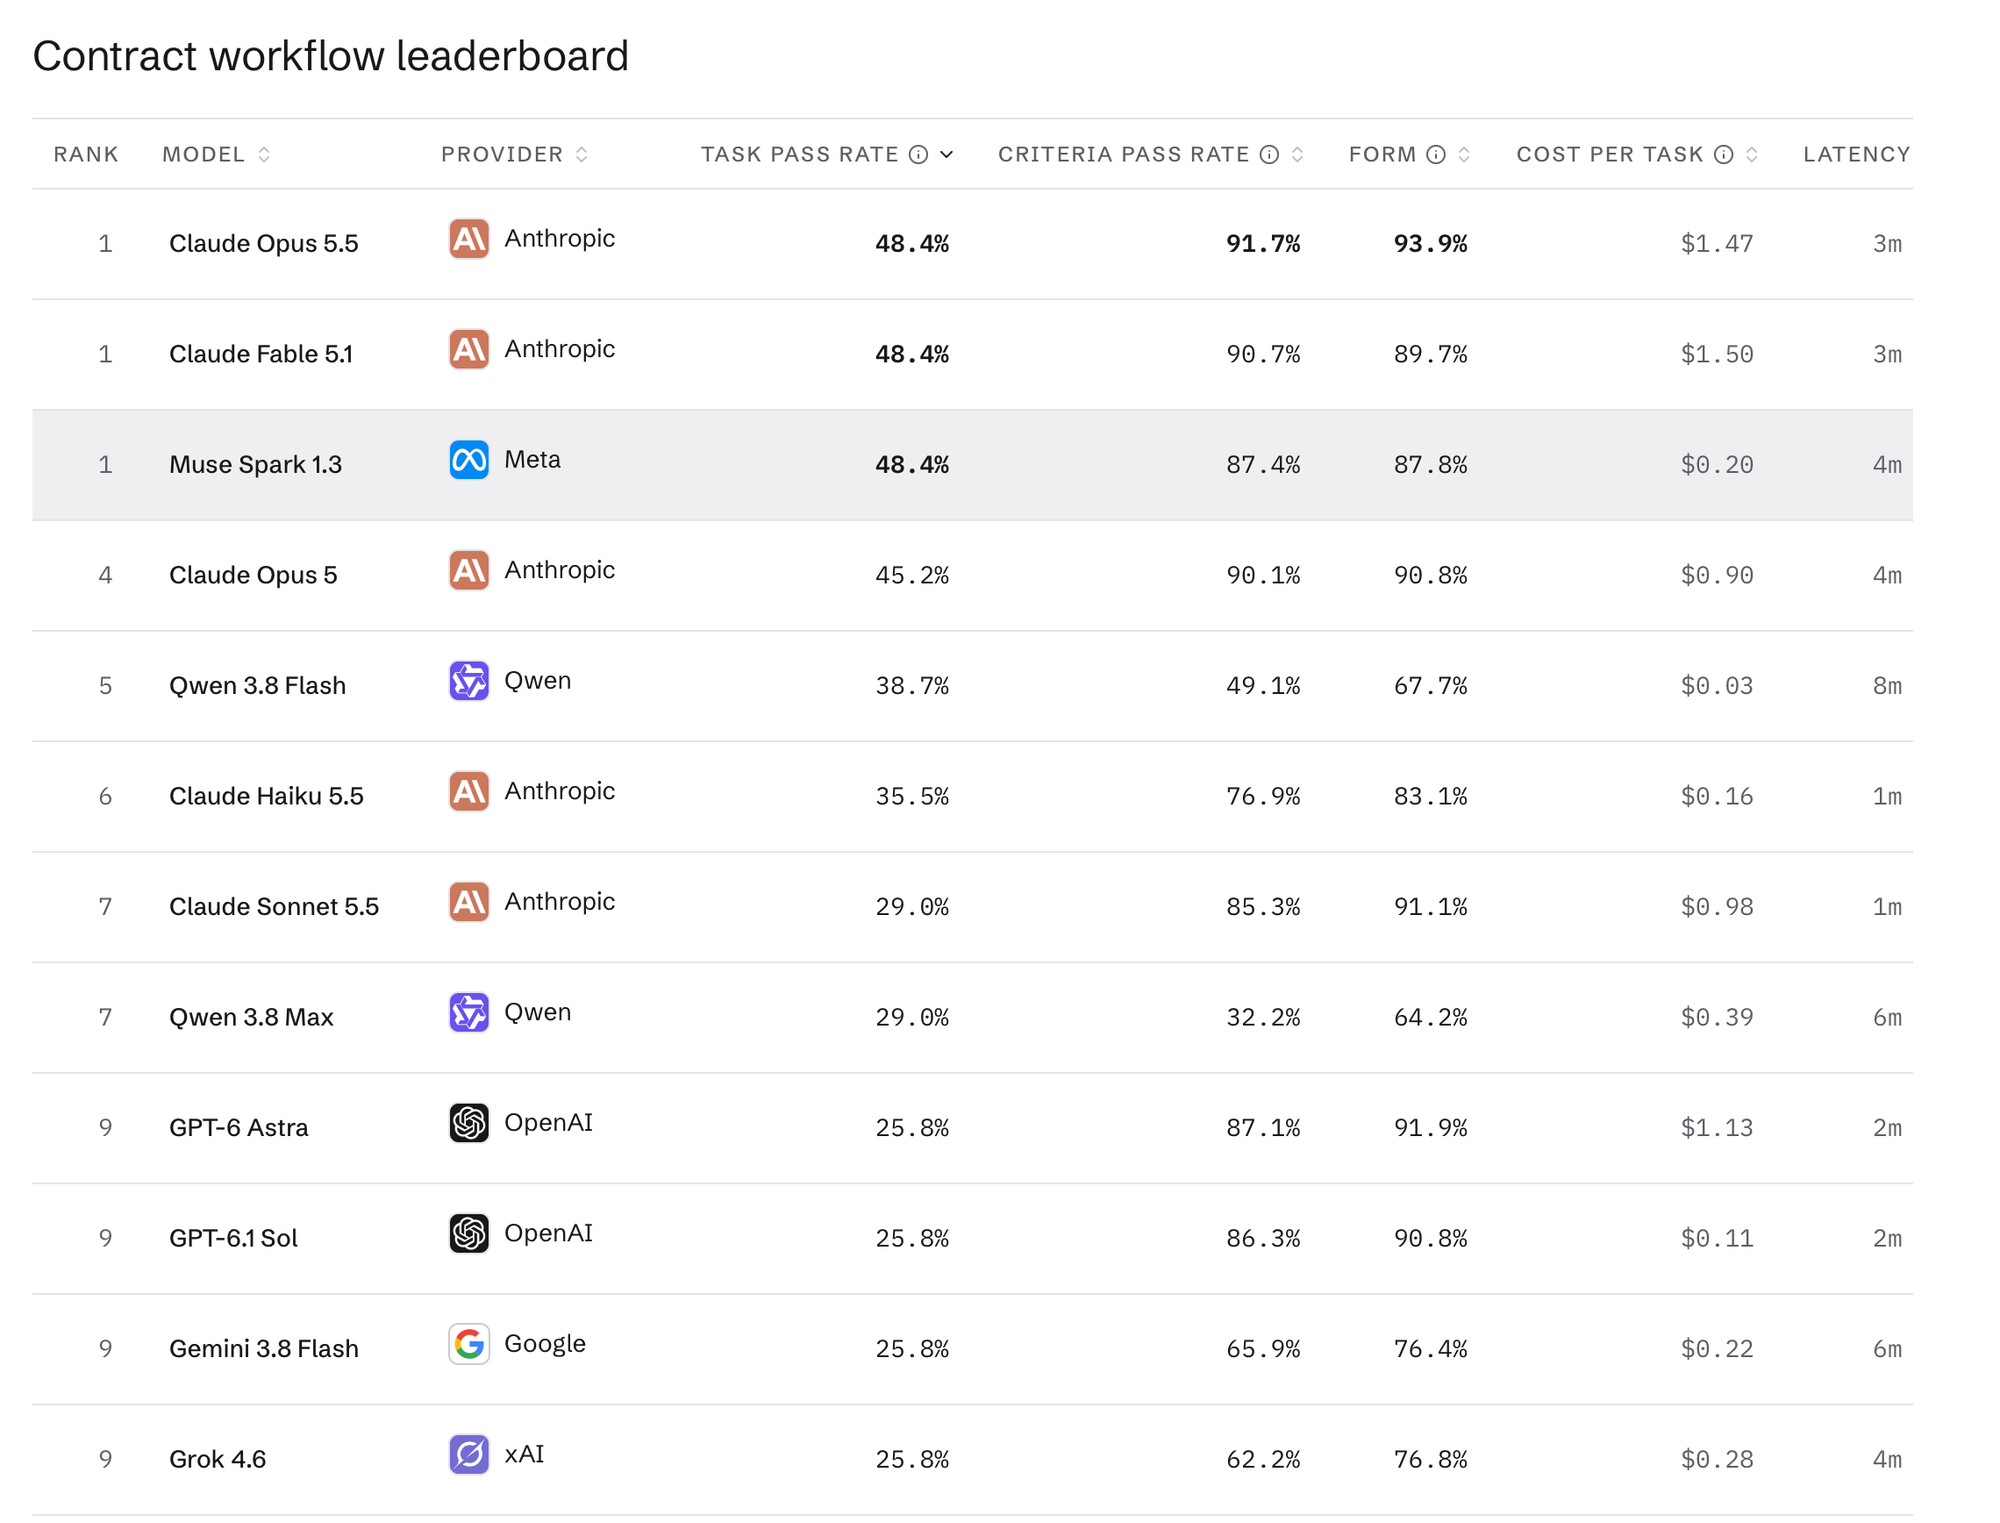
Раньше модель получала задачу одним запросом по API и отвечала текстом. С августа модели работают в агентной обвязке: в изолированном рабочем пространстве с одинаковым для всех набором инструментов, включая общий инструмент чтения документов с распознаванием сканов, и сдают результат файлами. Также обновили набор задач и ввели строгий зачёт по задаче целиком, поэтому авторы сами предупреждают, что новые цифры нельзя сравнивать со старыми. С сентября каждую задачу модель решает дважды, и задача засчитывается, только если пройдена в обеих попытках. Тогда же появился отдельный лидерборд приложений: продукты тестируют через их обычный интерфейс, как это делал бы клиент. На октябрьском снимке в драфтинге договоров наверху тройная ничья на 48,4%, причём Muse Spark 1.3 от Meta стоит примерно на 86% дешевле двух моделей Claude, которые делят с ним первое место.
Изменилась и институциональная часть: Legal Benchmarks начал брать деньги с вендоров. Вендор юридического ИИ может заказать оценку своего продукта в публичном или приватном варианте (Get benchmarked). В публичном варианте результат и место в рейтинге публикуются, каким бы ни оказался результат. В приватном вендор получает конфиденциальный отчёт с разбором ошибок и сравнением с усреднённым «Legal AI average» и уже после этого решает, публиковать ли его; нераскрытые результаты при этом всё равно входят в средний показатель. Перепройти оценку можно один раз за цикл, тоже за плату, и засчитывается повторный результат, даже если он хуже первого (в рейтинге он помечается как повторный).
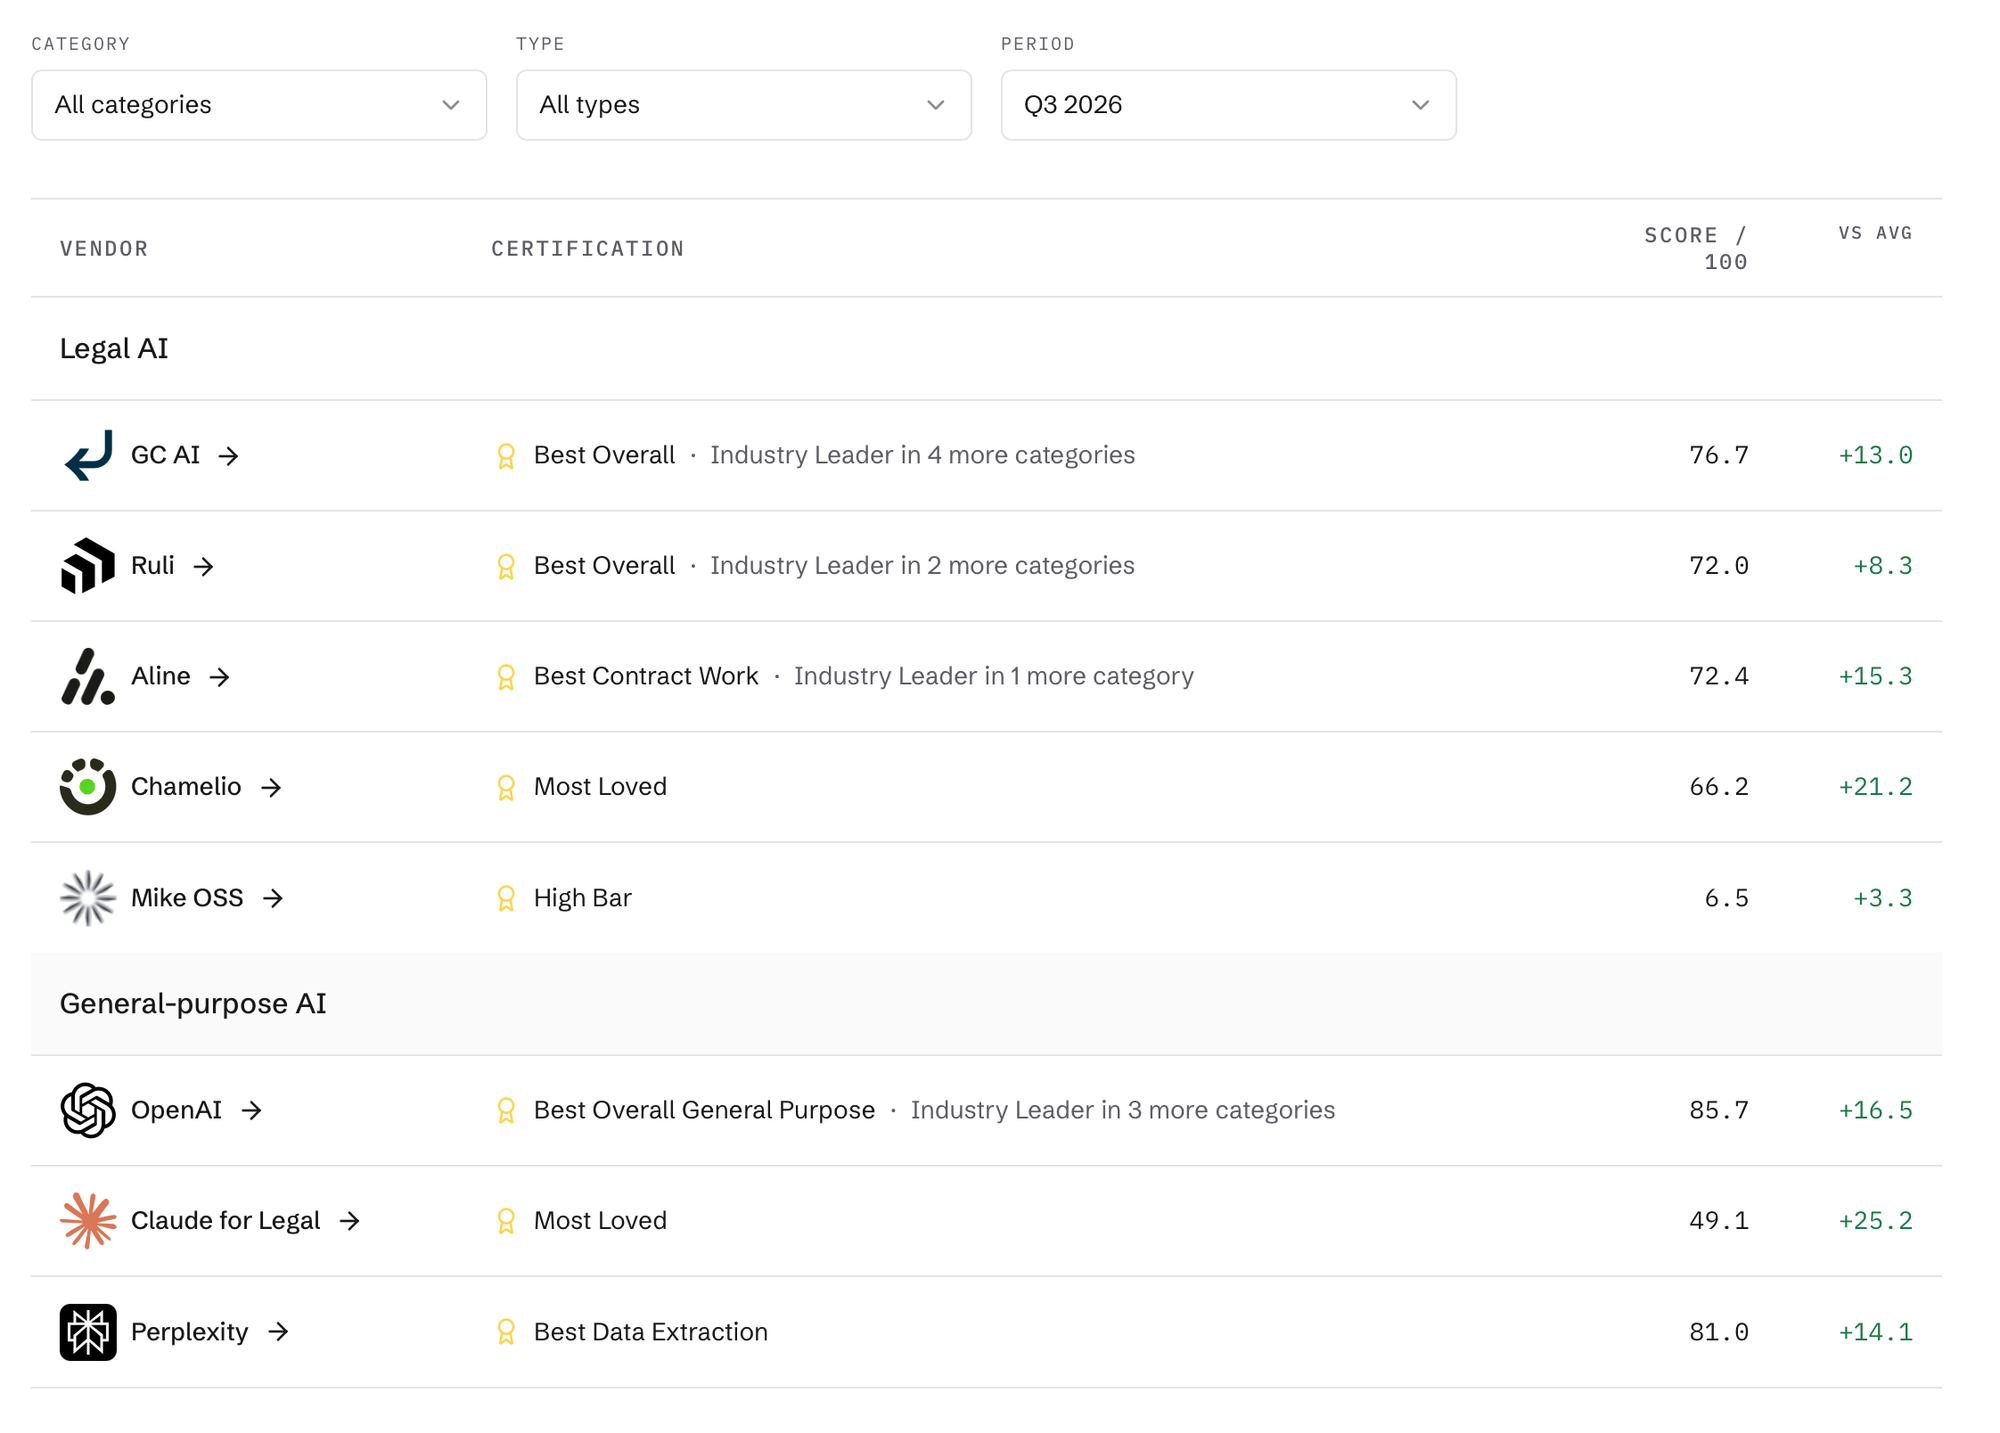
Продукты из обоих вариантов участвуют в отборе на сертификаты Industry Leader, которые присуждаются дважды в год. Первые сертификаты за третий квартал 2026 года получили несколько американских продуктов, например GC AI (ИИ-ассистент для инхаус-юристов, который отвечает на правовые вопросы, составляет и правит договоры, в том числе прямо в Word) и Aline (система управления договорами для небольших юридических отделов, где драфтинг, ревью, подписание и поиск по договорам собраны в одном месте).
На странице их закупочного фреймворка по-прежнему заявлен принцип «без вендорского спонсорства и коммерческого влияния». Плата, по их словам, покрывает стоимость самого прогона: администрирование задач, сбор ответов, оплачиваемую проверку практикующими юристами и подготовку результатов. То есть платят за прогон, а не за результат («The fee funds the evaluation itself, never the outcome»), повлиять на баллы вендор не может, а коммерческие отношения с измеряемым вендором раскрываются в отчёте.
Если суммировать, Legal Benchmarks собрал вполне жизнеспособную модель: задачи даёт сообщество, а прогон оплачивает вендор. Независимость при этом получается неполной: вендор может сначала пройти приватную оценку и опубликовать результат, только если тот его устроил. Недовольные своим результатом в публичную таблицу не попадают, поэтому она, кажется, не совсем объективна: происходит то самое размывание.
В сентябре Legal Benchmarks выпустил ещё и DELTA, бенчмарк правового исследования по праву Нидерландов, и для нас это, кажется, самый близкий аналог национального бенчмарка в неанглоязычной юрисдикции. Вопросы собраны из более чем 200 исследовательских заданий нидерландской практики, задачи и результаты проверяли юристы 12 фирм-партнёров, а меряют в DELTA только модели. Лидер, Claude Fable 5.1, полностью проходит 15% задач. Часть задач выложена на GitHub, и у каждой задачи указана дата, на которую верен эталон.
Но есть нюанс, который хорошо показывает, почему независимость — это спектр: партнёр-основатель DELTA — нидерландский юридический ИИ-вендор Zeno. Его продукт — исследовательская система, которая связывает между собой законы, судебную практику и доктрину и работает поверх моделей OpenAI, Anthropic и Google. В анонсе партнёрства Zeno пишет, что Legal Benchmarks сам предложил им участие: Zeno вносит технический опыт в дизайн оценки, а методология, анализ и выводы остаются за Legal Benchmarks. Там же они прямо проговаривают, что собственную работу не оценивают: в DELTA меряют модели, а не продукты. Очень оригинальный и аккуратный подход вендора к организации публичного бенчмарка.
В общем рынке похожая конструкция однажды обернулась скандалом. Математический бенчмарк FrontierMath финансировала OpenAI, у неё был доступ к большей части задач, а раскрыли это только тогда, когда OpenAI объявила о рекордном результате своей модели o3 на этом бенчмарке (TechCrunch). У DELTA, судя по анонсам, роль партнёра раскрыта с самого начала, но пример объясняет, почему связи партнёров стоит раскрывать заранее, а не задним числом.
3. Академия
Сильные стороны академии — незаинтересованность и техническая строгость. Многое из того, что вообще известно о надёжности коммерческих правовых систем, пришло из академических аудитов (например, из замера по обзорам законодательства 50 штатов, о котором я писала в третьей части). Слабые стороны в обзорной литературе описывают так: денег на масштаб нет; доступа к продуктам нет, потому что многие юридические ИИ-системы продаются только институциональным клиентам; нормы публикации требуют открыть датасет, после чего он быстро протухает.
И, пожалуй, главная слабость, общая для академических бенчмарков в любой области: повторный прогон новых систем на уже существующем бенчмарке почти ничего не даёт исследователю. Научная карьера и гранты держатся на новизне: первый бенчмарк по новой задаче можно опубликовать, а замер свежих моделей на старом — нельзя. Поэтому регулярность академия не обеспечивает. Академический аудит — это однократный снимок, а хороший академический бенчмарк быстро становится историей (как LegalBench, о котором была вторая часть).
4. Консорциум участников рынка
Элемент консорциума мы уже видели: задачи для первого VLAIR писал консорциум юрфирм. В обзорной литературе предлагают полноценный многосторонний консорциум по образцу двух известных проектов из общего рынка оценки. Первый — юридический трек в TREC. TREC — это ежегодная конференция по оценке поисковых систем, которую проводит американский NIST (государственный институт стандартов), и в 2006–2011 годах в ней был отдельный трек по поиску документов для e-discovery (раскрытия доказательств в американском процессе), где релевантность найденного оценивали юристы. Второй — MLPerf, набор бенчмарков производительности железа и софта для машинного обучения, который с 2018 года вместе развивают исследователи и компании, сейчас в рамках некоммерческого консорциума MLCommons.
В таком консорциуме регуляторы выбирают задачи, академия отвечает за процедуры построения и оценки, покупатели дают деньги и юридическую экспертизу, вендоры помогают технически, а адвокатские палаты засчитывают юристам участие в разметке как непрерывное образование.
Для консорциума предсказывают несколько проблем:
- участники очень разные: глобальная фирма с собственной ИТ-командой, небольшое бюро, инхаус, юридическая клиника. Повестку, скорее всего, будут задавать крупнейшие, и задачи сместятся к тому, чем занимаются они (сделки M&A, финансирование, крупные корпоративные проекты), а не к тому, с чем приходят к частнопрактикующему юристу;
- тем, кто вложился в замер деньгами и временем, невыгодно, чтобы результатами бесплатно пользовались все остальные, поэтому они будут добиваться отсрочки публикации или закрытого доступа к результатам;
- по мере того как крупные фирмы заводят собственные ИИ-команды и учатся сами оценивать инструменты, общий замер им нужен всё меньше, и мотивация участвовать падает.
Не представляю такого консорциума у нас и в теории: юристы вообще мало о чём могут договориться между собой даже в масштабе маленького LegalTech-сообщества, что уж говорить о чём-то, что будет включать крупнейшие юрфирмы и государство.
5. Государство
У государства есть мандат представлять общественный интерес, но обычно нет экспертизы и бюджетов на сложное конструирование бенчмарков. В неюридических областях роль независимого оценщика государству удавалась. Везде в пример приводится ранее упомянутый американский NIST, который с начала 2000-х тестирует присланные вендорами алгоритмы распознавания лиц на закрытых данных и публикует результаты; программа работает непрерывно и сейчас называется FRTE/FATE. В юридическом ИИ государства пока становятся чем-то другим:
- Сингапур. Государственное агентство по цифровому развитию IMDA вместе с Сингапурской академией права, которой принадлежит главная правовая база страны LawNet, разработало собственную юридическую модель GPT-Legal. С 2025 года она работает в LawNet как поиск с ответами на вопросы по договорному праву, то есть агентство само выступает разработчиком юридического ИИ. Весной 2026 года IMDA договорилась с американской Scale AI о совместной работе, и первый проект — крупный бенчмарк по праву Сингапура (Scale AI). Это ближе всего к государственному юридическому бенчмарку, но с оговорками: мерить будут модели, а не продукты, а Scale AI продаёт обучающие данные тем самым лабораториям, чьи модели будут измеряться.
- Великобритания. В августе 2026 года британское правительство открыло приём заявок в AI Growth Lab для юридических услуг. Это песочница, где разработчики ИИ-продуктов вместе с регуляторами юридического рынка и защиты данных разбираются, как к их продукту применяются действующие правила. Среди примеров на сайте есть фирма по сделкам с жилой недвижимостью, которая делает инструмент для разбора документов продавца: он помечает места, которые юристу стоит проверить внимательнее. В песочнице фирма хочет придумать, как убедить пользователя, что инструмент отработал корректно. Доказывать, что инструмент работает, по-прежнему должен сам вендор: песочница помогает разобраться с регуляторикой, но ничего не меряет.
Так что ни одно государство пока не стало независимым арбитром качества юридического ИИ.
Надстройки: раскрытие и сводные индексы
Британская ассоциация Litig честно попробовала сделать открытый стандартизированный бенчмарк и отступила. В описании инициативы сказано, что из-за сложности с согласованием метрических бенчмарков они сначала занялись общим пониманием и подходом к прозрачности, а сейчас думают, куда двигаться дальше. Результат — декларация о прозрачности, которую организации подписывают (у них она называется Transparency Charter), и форма раскрытия о продукте: какие модели в основе, для чего продукт предназначен, какова производительность, ограничения, как проводилось тестирование, этические соображения. На мой взгляд, это интересный подход, и его могли бы взять на вооружение компании, закупающие ИИ-решения по внутренним конкурсным процедурам.
Как институт такая конфигурация слабее. Декларация не требует раскрывать конфиденциальную информацию, а за соблюдением рабочая группа обещает следить и реагировать, если узнает о нарушениях. В реестре сейчас 11 подписантов, зарегистрированных с октября 2025 по апрель 2026 года, в основном вендоры: среди них Harvey, Legora, Relativity и даже британское подразделение LexisNexis, которое своих замеров не публикует. Сами документы не обновлялись с сентября 2025 года.
Сводные индексы собирают чужие замеры на одну доску, которую легко процитировать. Например, Artificial Analysis (AA), независимая компания из общего рынка оценки ИИ, которая тестирует модели по качеству, скорости и цене (она же прогоняла Harvey LAB), публикует Legal Index. Но из семи бенчмарков, которые стоят за индексом, собственно юридических только два (на знание права и на галлюцинации в праве), а остальные общие, вроде «Последнего экзамена человечества». То есть больше половины веса «юридического» индекса приходится на тесты, которые на право не смотрят. Сама AA при этом оговаривается, что для конкретного сценария отдельные бенчмарки могут быть информативнее сводного балла.
Есть и сайты-витрины вроде BenchLM, которые сами ничего не меряют, а собирают результаты чужих бенчмарков в одном месте. Юридического раздела у них пока нет. Отдельные юридические замеры на BenchLM встречаются: например, зеркало Legal Research Bench от Vals или результат Claude Opus 5 на LAB, взятый из системной карточки самой Anthropic. Но они разбросаны по общим категориям, показаны только для справки и в рейтинг не входят. Витрины, которая собрала бы юридические замеры вместе, с разрезами и пометкой, кто мерил, пока нет. Мне кажется, это вполне реализуемая идея.
Соберём все в единую красивую схему?
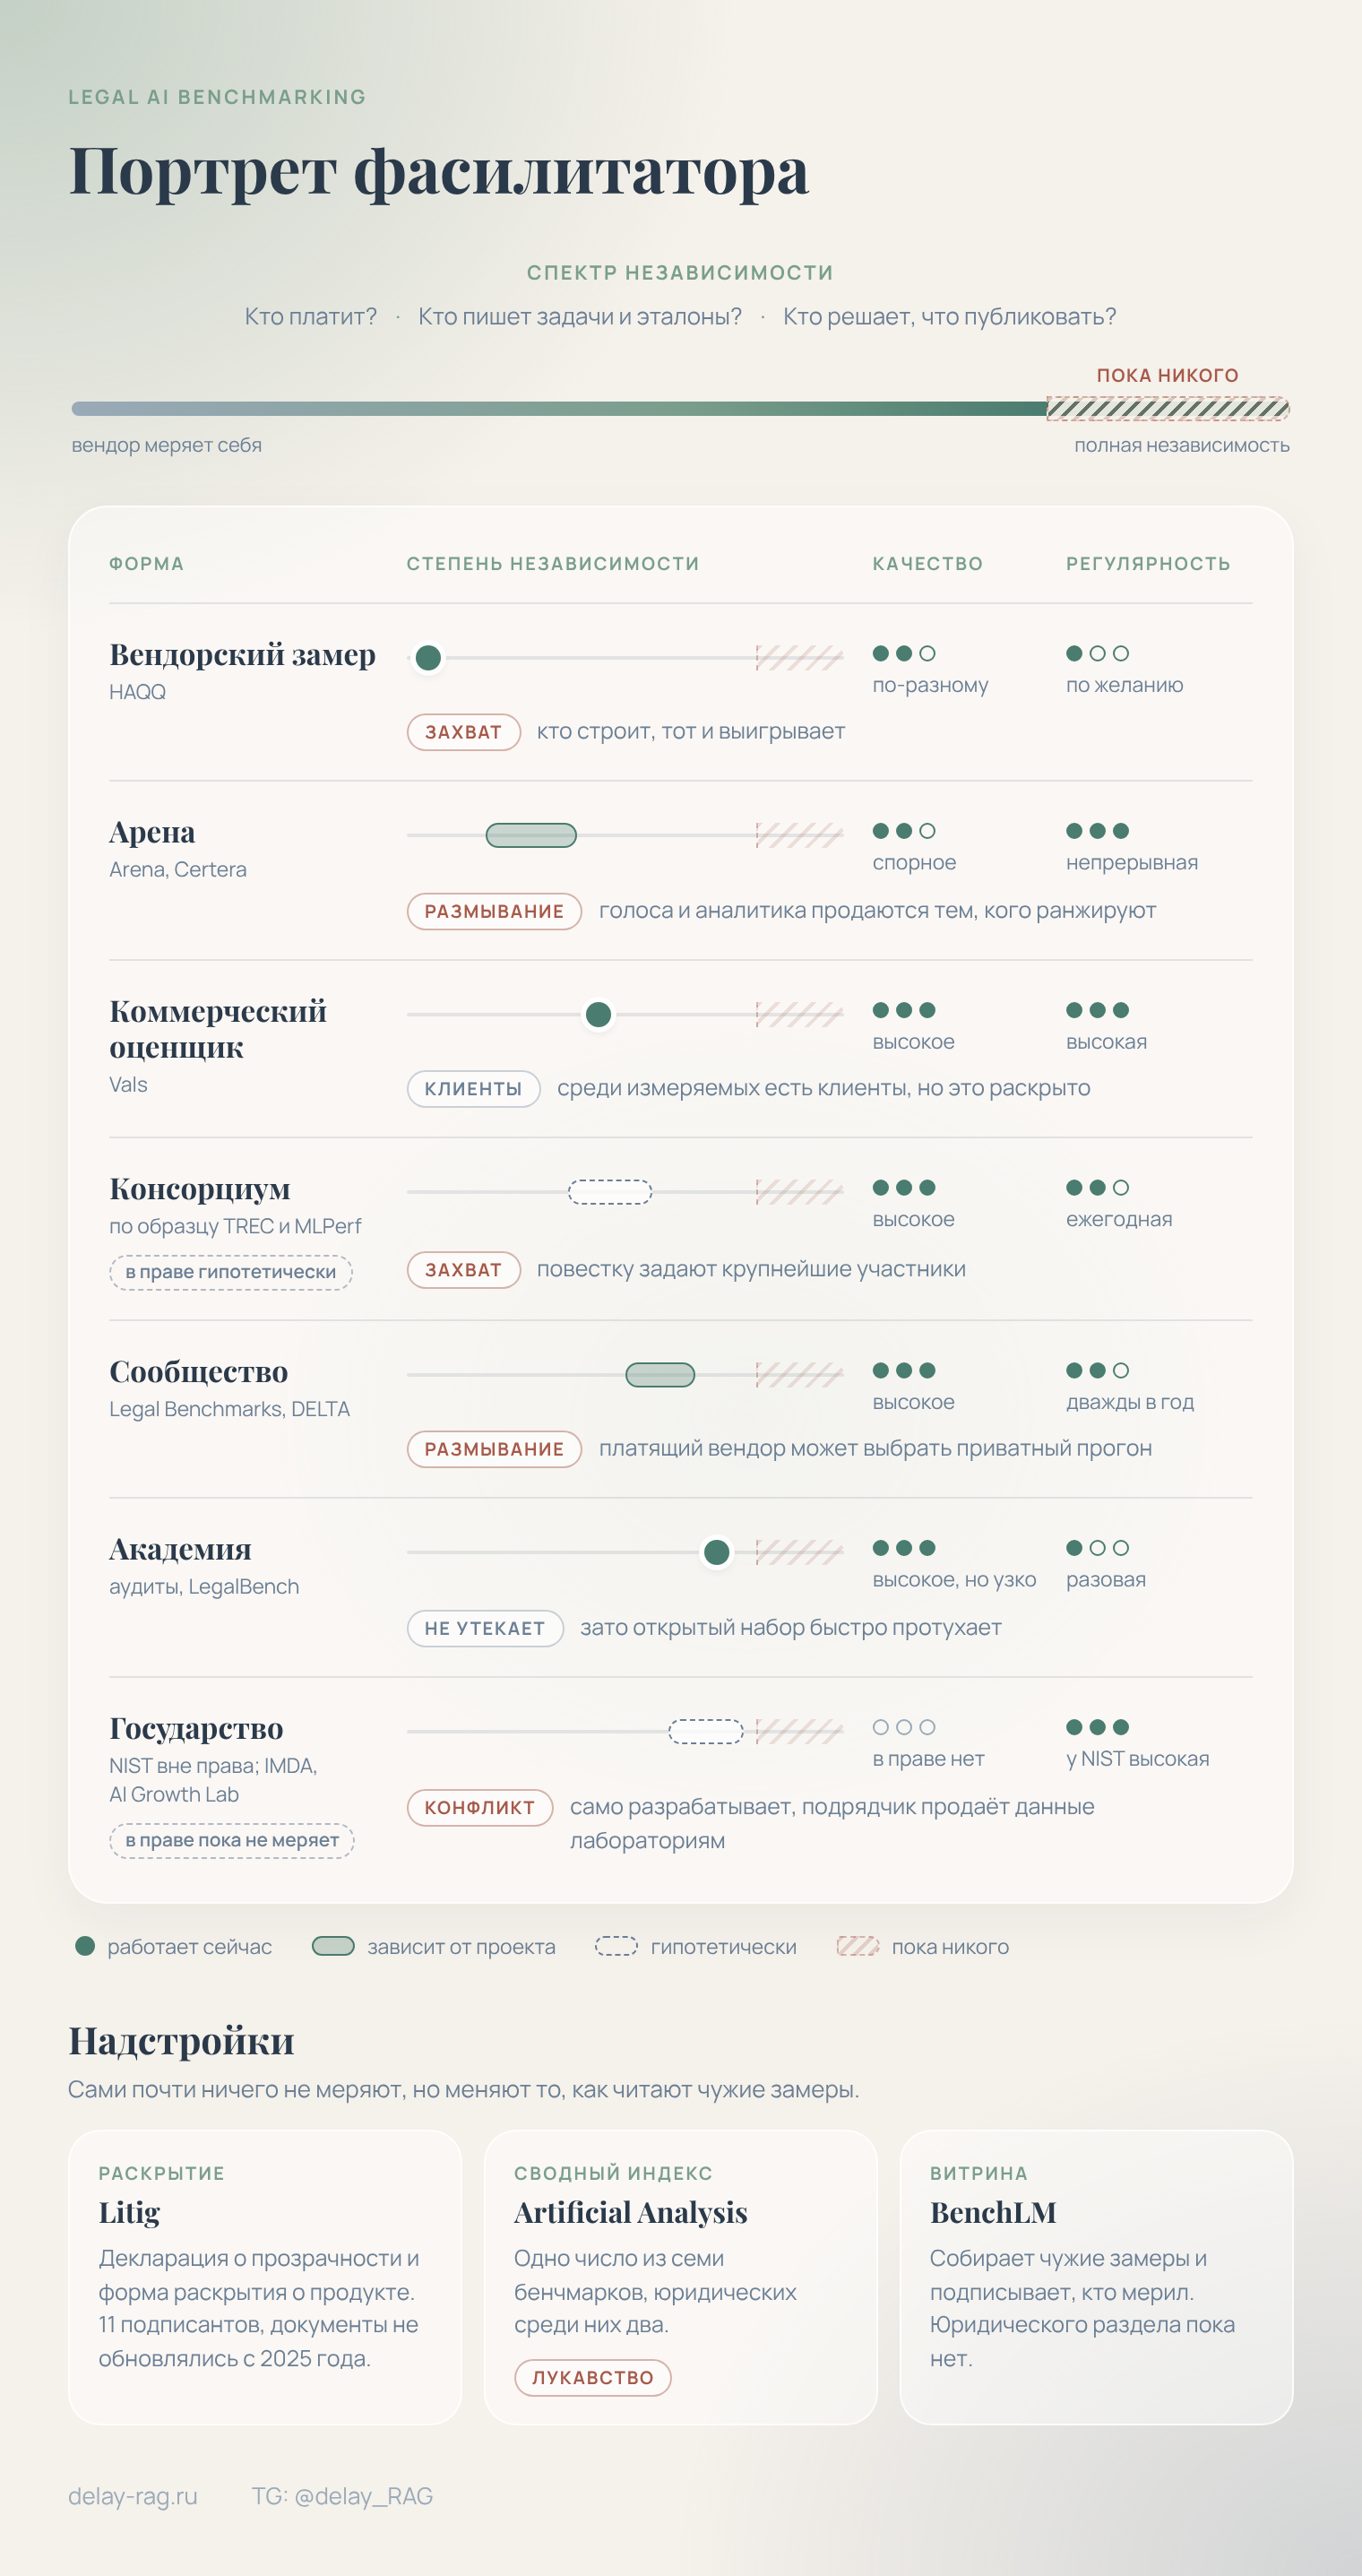
Что должен уметь фасилитатор?
Часть этих правил уже звучала в третьей части как методика, а истории выше показывают, где без них всё начинает расползаться. Вместе получается примерно такой список ожиданий к тому, кто претендует на независимый замер:
- раскрывать источники финансирования и клиентские связи, причём не только свои, но и партнёров и авторов задач;
- публиковать список участников замера: кого позвали, кто прошёл замер, кто отказался или отозвал результат;
- заранее публиковать протокол: какие задачи и в каких пропорциях, как оценивают, кого допускают и что публикуют;
- ставить дату снимка и вести changelog;
- давать возможность оспорить эталон;
- публиковать тематические разрезы, а не только сводный балл.
Отдельный вопрос с подвохом: можно ли требовать, чтобы результат публиковался независимо от того, понравился ли он вендору, который заплатил за замер? Компромиссом мог бы быть публичный список участников, где имя продукта есть, а его балла нет. Например: «замер прошли 14 продуктов, результаты опубликованы для 9; не дали согласия на публикацию X, Y и Z». Цифр этих трёх продуктов читатель не увидит, но будет знать, что они замер проходили и показывать результат не захотели.
А что у нас?
Российский рынок устроен так: основа большинства продуктов — это RAG по какому-то корпусу плюс API известной СПС, может, набор экспертных системных промптов и шаблонов. Модель под капотом почти никто не раскрывает, продуктов много и снаружи они малоразличимы, заказчика, готового платить за независимый замер, не существует в природе.
Кое в чём мы однозначно в лучшем положении, чем коллеги на Западе: у нас не требуется согласие вендора для замера. Даже если представить пользовательское соглашение, которое запрещает бенчмаркинг, публикация будет максимум нарушением договора с последствиями вроде блокировки доступа, что не очень страшно. Защититься от честного и неподкупного ревизорро-замера могут только сервисы, которые продаются исключительно корпоративным клиентам по индивидуальному договору, но таких у нас абсолютное меньшинство. Получается, что доступ к продуктам, о который споткнулись западные фасилитаторы, у нас не главная проблема. Из трёх свойств хорошего бенчмарка из начала текста всё упирается в то, кто оплатит качество и регулярность и останется при этом независимым.
Что гипотетически может появиться вне сообщества LegalTech-энтузиастов:
- Вендорские бенчмарки, где вендор на первом месте. Полезны они будут настолько, насколько открыты промпты и баллы (как у HAQQ).
- Медийные «рейтинги лучшего юридического ИИ» с одним сводным баллом и без разрезов.
- Юридический трек в MERA. Развивают MERA (российский открытый бенчмарк языковых моделей) участники Альянса в сфере ИИ, то есть в основном сами разработчики моделей, и результаты на лидерборд присылают тоже они. Права там нет: отраслевой трек MERA Industrial пока состоит из двух задач по сельскому хозяйству и одной по медицине. По словам авторов, они оценивают прежде всего возможности самой модели и поэтому не добавляют агентные, reasoning- или tool-обвязки. Так что если юридический трек и появится, мерить он будет модели, а не сервисы, из которых состоит наш рынок.
- Государственное участие — скорее через регулирование, чем через замер. Мне кажется, у нас вообще предпочитают вопрос зарегулировать, а не измерить. И если государство внезапно для всех обратит всевидящее око на юридический ИИ, то, скорее всего, через социально значимые сервисы для граждан. Человек с вопросом про банкротство, ЖКХ, алименты или увольнение, чаще всего спрашивает обычную нейросеть или бесплатного бота, и цена ошибки для него высокая. Но ждать от государства независимого замера качества таких сервисов, по-моему, не стоит; вероятнее, просто появятся требования к ним.
- Стандартная форма раскрытия по образцу Litig. Сразу с пониманием, что откликнутся немногие, пока её не начнут спрашивать покупатели.
Какие перспективы у экспертного сообщества без денег?
- Задачи от сообщества и способы получить экспертное время без денег: pro bono от фирм, публичное авторство задач, может, какая-то платформа с геймификацией, ачивками и встречной ценностью для авторов задач. В обзорной литературе предлагают ещё, чтобы адвокатские палаты засчитывали участие в разметке в повышение квалификации.
- Регулярный замер обычных нейросетей и купленных сервисов на открытом харнессе в тех областях, где ошибка ИИ сильнее всего бьёт по людям без денег на юриста (как раз те вопросы граждан, о которых я писала в пункте про государство).
Регулярно мерить продукты с разрезами по сценариям и, может, даже выдавать сертификат, который что-то значит для покупателя (например, в закупках), можно только за деньги. Legal Benchmarks показывает, откуда эти деньги берутся на практике: от вендоров. А вместе с ними приходят и уступки в правилах публикации. То же самое и с аренами: кто-то должен платить за хостинг, следить за актуальностью вопросов, организовывать получение ответов от сервисов, вести лидерборд и чинить баги, а для доступа к сервисам, опять же, нужны контакты с вендорами. Короче говоря, диагноз: самодостаточный независимый оценщик, который сам решает, что мерить, и сам за это платит, в обозримом будущем мне кажется нереалистичным.
Дочитавшим в награду интерактивная кнопочная: собери портрет своего российского бенчмаркера и поставь ему диагноз. Спасибо за ваш интерес к моей работе!
меряет себяполная
независимость