Legal AI Benchmarking: как это делают там. Часть 1: независимые фасилитаторы
Первая часть большого обзора о том, как на западном рынке оценивают AI-продукты на юридических задачах.
В декабре я выкладывала результаты делай_bench и собранную после него обратную связь сообщества. С тех пор меня волнует методология проведения бенчмарков Legal AI-продуктов: у отрасли много узких мест и в силу самой доменной специфики, и в контексте сложившегося ландшафта рынка AI-LegalTech продуктов.
Изыскания по одному из предыдущих проектов — попытке сделать замер оптимального устройства RAG-систем судебной практики — привели меня к открытиям о том, как бенчмаркинг ИИ-продуктов делают на западе. У коллег богатый на инсайты опыт, и мне захотелось сделать об этом серию публикаций.
- Часть 1: Независимые фасилитаторы — Vals AI и Legalbenchmarks.ai, вы читаете этот пост.
- Часть 2: Академия и вендоры — обзор работы группы учёных крупного американского университета, признанного российскими государственными органами нежелательной организацией, а также то, как свои замеры делают Harvey, Thomson Reuters, LexisNexis.
- Часть 3: Методологические выводы — метаобзор методов, оценка их переносимости на нашу почву, на которой AI-LT продукты растут аки грибы, мысли о судьбах российского Legal AI-бенчмаркинга.
Начинаю с независимых, потому что те, кто меня знают, знают, насколько меня волнует тема независимых коммьюнити-управляемых бенчмарков.
Vals AI
Vals AI, Inc. — американская компания: настолько солидно, что даже есть раздел «Карьера» на сайте. Делает приватные отраслевые бенчмарки (право, налоги, финансы) и продаёт инфраструктуру оценки лабораториям и инженерным командам. Себя описывает как независимую платформу, хотя оговаривает, что имеет клиентские отношения с одним или несколькими участниками исследования.
В Vals считают, что популярные бенчмарки построены на надуманных академических датасетах; живые лидерборды скомпрометированы, потому что открытые датасеты попадают в предобучающие корпуса, а недобросовестные игроки дообучают модели прямо на оценочных наборах; результаты, которые публикуют разработчики моделей, предвзяты по построению.
На эти проблемы они отвечают любопытным устройством тестовых наборов данных. Каждый бенчмарк Vals разбит на три части:
- Public Validation Set — полностью открытый набор образцов, чтобы методику можно было оценить со стороны
- Private Validation Set — больший приватный набор, лицензируемый компаниям для внутренней валидации: вендоры могут проверить себя, не получив тест. Vals прикладывает статистическое доказательство того, что он коррелирует с тестовым
- Test Set — приватен всегда, чтобы защищаться от утечки в датасеты для фундаментальных моделей. Только на нём собственно и делаются замеры.
Теперь посмотрим на три юридических исследования Vals, там буквально драма в трёх актах.
VLAIR, февраль 2025: замеры юридических продуктов
Первый Vals Legal AI Report оценивал продукты: CoCounsel (Thomson Reuters), Vincent AI (vLex), Harvey Assistant, Oliver (Vecflow). Дизайн разрабатывался совместно с Legaltech Hub.
Методика
На чём проверяли
На семи типах задач или, как мы их часто называем, сценариях юридической работы:
- извлечение данных
- Q&A по документу
- суммаризация
- редлайнинг (внесение исправлений в документы)
- анализ транскриптов
- построение хронологий
- поиск по EDGAR (официальная электронная система Комиссии по ценным бумагам и биржам США (SEC), предназначенная для автоматического сбора, проверки, индексации и публикации финансовой отчётности компаний).
Список собирали опросом самих юрфирм: Vals пишет, что консенсуса о том, где генеративный ИИ полезнее всего, в отрасли не существует. Оси «отрасль права», как вы можете заметить, в дизайне нет.
Задачи писал консорциум фирм (Reed Smith, Fisher Phillips, McDermott Will & Emery, Ogletree Deakins + четыре анонимные): больше 500 комплектов «вопрос — эталонный ответ — критерии корректности», с пометкой, юрист какого уровня обычно это делает.
Человеческий baseline
Модели сравнивали с ответами живых юристов. Юристов нашла и координировала ассоциация Cognia Law:
Юристы получали задания в том же формате, как если бы они пришли от обычного клиента, — они не знали, что участвуют в бенчмарк-исследовании.
Как считали
Оценивала ответы сервисов проприетарная автоматизированная инфраструктура Vals, LLM-as-a-judge. Ручная оценка всех выходов заняла бы у одного человека больше 400 часов, при этом Vals признаёт, что LLM-судья «не замена экспертному человеческому оценщику», и что проваленные ответы дополнительно перепроверяли вручную.
LLM-судье давали эталонный ответ и инструкцию, как этот элемент проверять; судья возвращает pass/fail с объяснением.
Каждый эталон содержит несколько чекпоинтов, описывающих корректность ответа. Балл за задачу складывался из количества набранных чекпоинтов. То есть 8 чекпоинтов из 10 — это 80%.
Результаты
| Юристы | CoCounsel | Vincent AI | Harvey | Oliver | |
|---|---|---|---|---|---|
| Извлечение данных | 71,1 | 73,2 | 69,2 | 75,1 | 64,0 |
| Вопросы и ответы по документу | 70,1 | 89,6 | 72,7 | 94,8 | 74,0 |
| Суммаризация | 50,3 | 77,2 | 58,9 | 72,1 | 62,4 |
| Редлайн | 79,7 | — | 53,6 | 65,0 | — |
| Анализ транскрипций | 53,7 | — | 64,8 | 77,8 | — |
| Построение хронологий | 80,2 | 78,0 | — | 80,2 | 66,9 |
| Ресёрч по базе EDGAR | 70,1 | — | — | — | 55,2 |
Живые юристы оказались лучше ИИ в правках документов и ресёрче по EDGAR, и сравнялись с Harvey по построению хронологий. Harvey с большим отрывом победил всех на ответах по документам. ИИ-продукты по скорости ожидаемо оказались быстрее юристов в 6–80 раз.
Оценивая Vincent AI, Vals столкнулись с той же проблемой, что и я в #делай_bench с сервисом АйЮрист:
Дело оказалось в критериях: набор чекпоинтов описывал только правильный ответ и не предусматривал легитимной альтернативной формы поведения. Другой бенчмарк-фасилитатор эту проблему решил, о чём расскажу ниже поподробнее.
Opt-in
Прочерки в таблице — не пропуски данных, а дизайн: каждый вендор сам выбирал, в какие задачи заходить, и имел право отозвать продукт — с отдельной задачи или из исследования целиком — до публикации.
Матрицу участия Vals публикует, и она информативнее результатов:
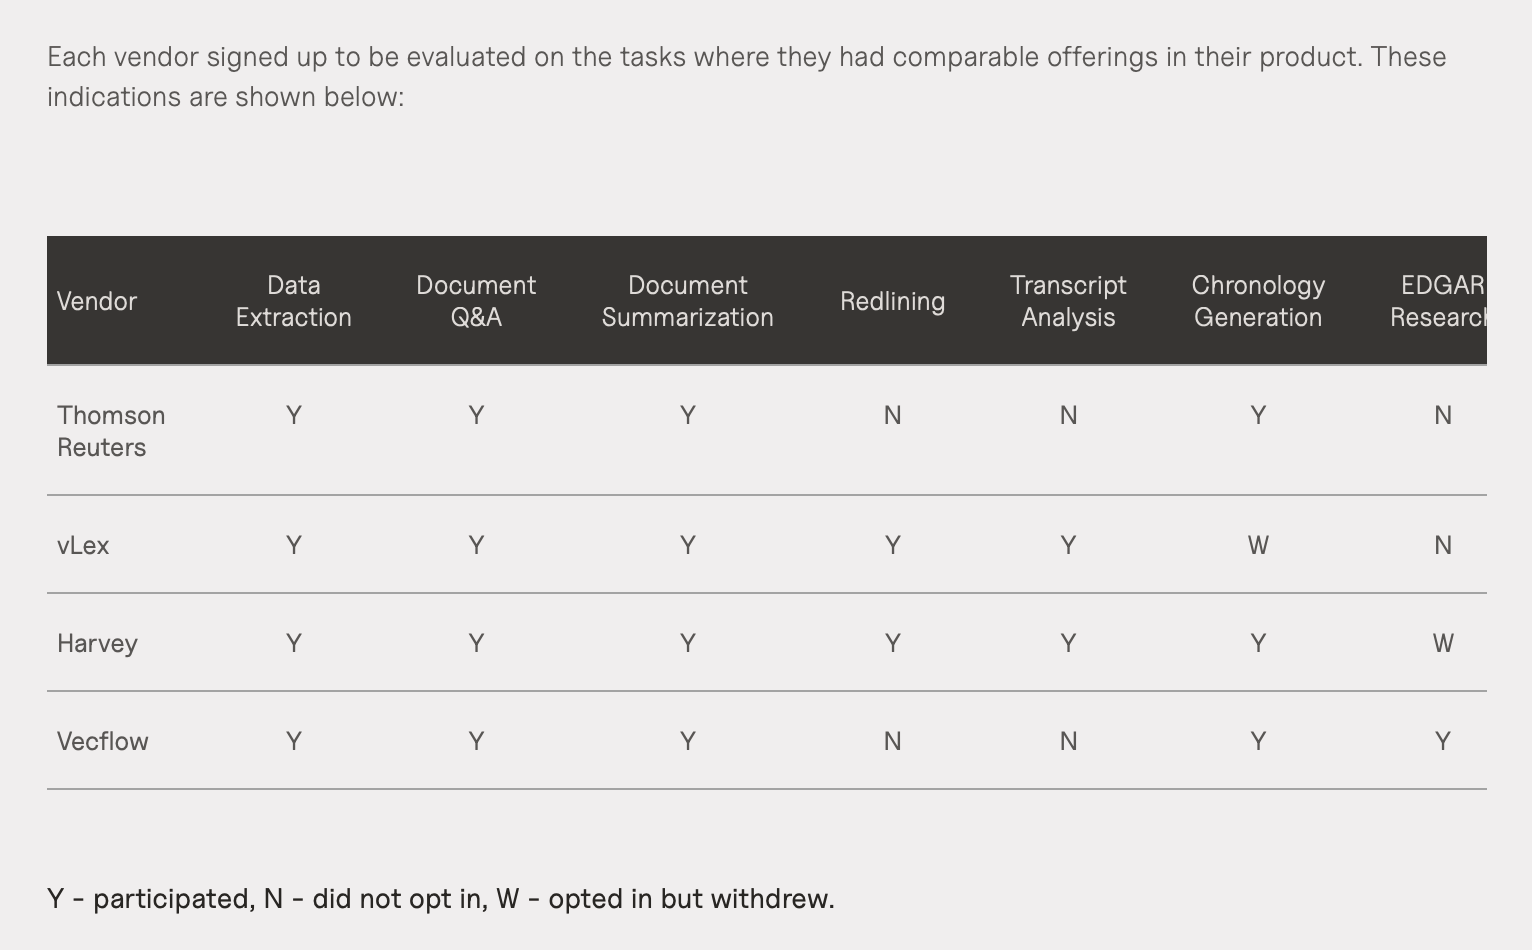
Отдельного упоминания заслуживает LexisNexis. Компания участвовала, но, как пишет Vals, после того как отчёт был написан, воспользовалась правом отозваться из задач по извлечению, суммаризации и Q&A; в отчёте её нет. Artificial Lawyer приводит объяснение самой компании: не совпали сроки, вышло крупное обновление Lexis+ AI, и тестировалась уже неактуальная версия.
VLAIR – Legal Research, октябрь 2025: только ресёрч
Второе исследование — целиком про правовое исследование. Участники: Alexi, Counsel Stack, Midpage и ChatGPT (включить модель общего назначения было самой частой просьбой после первого отчёта).
Thomson Reuters, LexisNexis и vLex — три крупнейшие платформы правового исследования — в бенчмарке не участвовали. Представители TR и LexisNexis не объясняли причин, почему не заходили в исследование. vLex сначала согласился, но отозвался до публикации: его представитель пояснил, что бенчмарк не был спроектирован под enterprise-инструменты.
Ось проверки: типы исследовательских вопросов
Для этого замера составили 200 комплектов «вопрос — эталонный ответ — источники — критерии корректности», распределённых по десяти типам исследовательских вопросов, в частности:
- подтверждение законодательного определения;
- суммирование позиции по названному судебному решению;
- поиск нормы или прецедента по фабуле;
- обзор права 50 штатов — самая тяжёлая категория, её провалили все участники;
- мультиюрисдикционные вопросы (14 штук) — сопоставить право нескольких юрисдикций;
- поиск только что изменившегося регулирования;
- точечный поиск данных в конкретном названном источнике;
- понимание отраслевых терминов — на этом типе юристы взяли 100%, а ИИ — от 3% до 80%.
Типы определяли вместе с юрфирмами консорциума и практикующими юристами по принципу «что реально встречается в частной практике». То есть сервисы снова сравниваются не по отраслям права, а по типам задач.
Вопросы подавались моделям через API как zero-shot промпт, каждый не менее трёх раз для снижения вариативности вывода.
Метрика: три взвешенных критерия
- Accuracy: верен ли ответ по существу, нет ли ошибок и пропусков относительно эталона. Вес метрики 50%, оценивается по шкале в 3 балла;
- Authoritativeness: Сослался ли на релевантные и действующие первоисточники, включая те, что есть в эталоне. Вес метрики 40%, оценивается по шкале в 3 балла;
- Appropriateness: Понятен ли ответ, можно ли сразу отправить коллеге или клиенту. Вес метрики 10%, оценивается по шкале в 2 балла.
Разведение accuracy и authoritativeness принципиально: правильный ответ без источника в праве не годится, и это отдельно измеримое свойство.
Кто оценивал
Здесь важное отличие от первого VLAIR: автоматической оценки не было вообще. Из-за потенциальной вариативности корректности любого ответа на исследовательский вопрос оценка проводилась вслепую группой юристов и правоведов-теоретиков.
Ответы анонимизировали (убирали ссылки на проприетарные источники, по которым опознаётся продукт; публичные ссылки оставляли, чтобы оценщик мог проверить). Каждый ответ оценивали минимум два оценщика, баллы усредняли, нулевые баллы перепроверял третий оценщик. Оценщикам выдавали эталон и критерии от юрфирм, но разрешали от эталона отступать, если он оказывался неполным, — чтобы не штрафовать ответы полнее эталона.
Что примечательно, среди оценщиков — Анна Гуо и Мохамед Аль Мамари из Legalbenchmarks.ai, о которых также будет в этом посте. Даже у них там на большом западе поле маленькое (и можно в него, думаю, без страха заезжать).
Результаты
Средневзвешенный балл: все четыре ИИ уложились в четыре пункта друг от друга (74–78%), человеческий baseline — 69%. По точности: юридические ИИ 78–81%, ChatGPT 80%, юристы — 71%.
- Авторитетность — единственная ось, где юридические ИИ отрываются от ChatGPT: 76% против 70% у ChatGPT. Vals связывает это с доступом к проприетарным базам. Единственная категория, где ChatGPT обошёл юридические ИИ по авторитетности, — вопросы, требующие самой свежей информации: у него по умолчанию веб-поиск, а юридические продукты намеренно ограничивают источники своими базами.
- Мультиюрисдикционные вопросы просаживают всех в среднем на 14 пунктов. Исключение — ChatGPT, у которого разброса не было.
- ИИ превзошёл baseline на 150 вопросах из 200, и там, где превзошёл, — в среднем на 31 пункт.
- Юристы выиграли 4 типа вопросов из 10, в среднем на 9 пунктов. Vals описывает эти типы как требующие «более глубокого понимания контекста, сложных мультиюрисдикционных обзоров и синтеза на основе суждения».
Legal Research Bench, июнь–июль 2026: модели вместо продуктов
Третье исследование устроено принципиально иначе: Vals больше не меряет продукты. Он меряет 18 фронтирных моделей, обвязанных одинаковым агентным харнессом с юридическими инструментами.
Логика перехода видна из предыдущих раундов: если вендоры не приходят, спрашивать разрешения больше не у кого. Модели, из которых сделаны продукты, доступны по API и согласия на измерение не требуют.
Методика
На чём проверяли
413 вопросов, написанных и отрецензированных практикующими юристами; у каждого — эталонный ответ, авторитетные источники и рубрики.
Датасет разбит по трёхчастной схеме: 5 публичных образцов / 200 в приватной валидации / 208 — тест, приватный навсегда; публикуются результаты только по тесту. Вопросы по этим частям распределены так, чтобы сохранить распределение типов вопросов, областей практики и сложности. Публичные образцы и сам харнесс выложены на GitHub — методику воспроизвести можно, данные — нет.
В харнессе у агента пять инструментов: поиск по практике (courtlistener_search по базе CourtListener), веб-поиск, извлечение информации из загруженных документов, парсинг HTML-страницы, отправка финального ответа. Лимит — три часа на задачу.
Рубрика и all-pass
Основная метрика — all-pass: вопрос засчитан, только если ответ удовлетворяет каждому пункту рубрики. Все прошли — 100%, хоть один не прошёл — 0%. Дополнительно считается weighted — доля набранных рубричных баллов, то есть тот самый частичный зачёт по чекпоинтам, который использовался в первом VLAIR.
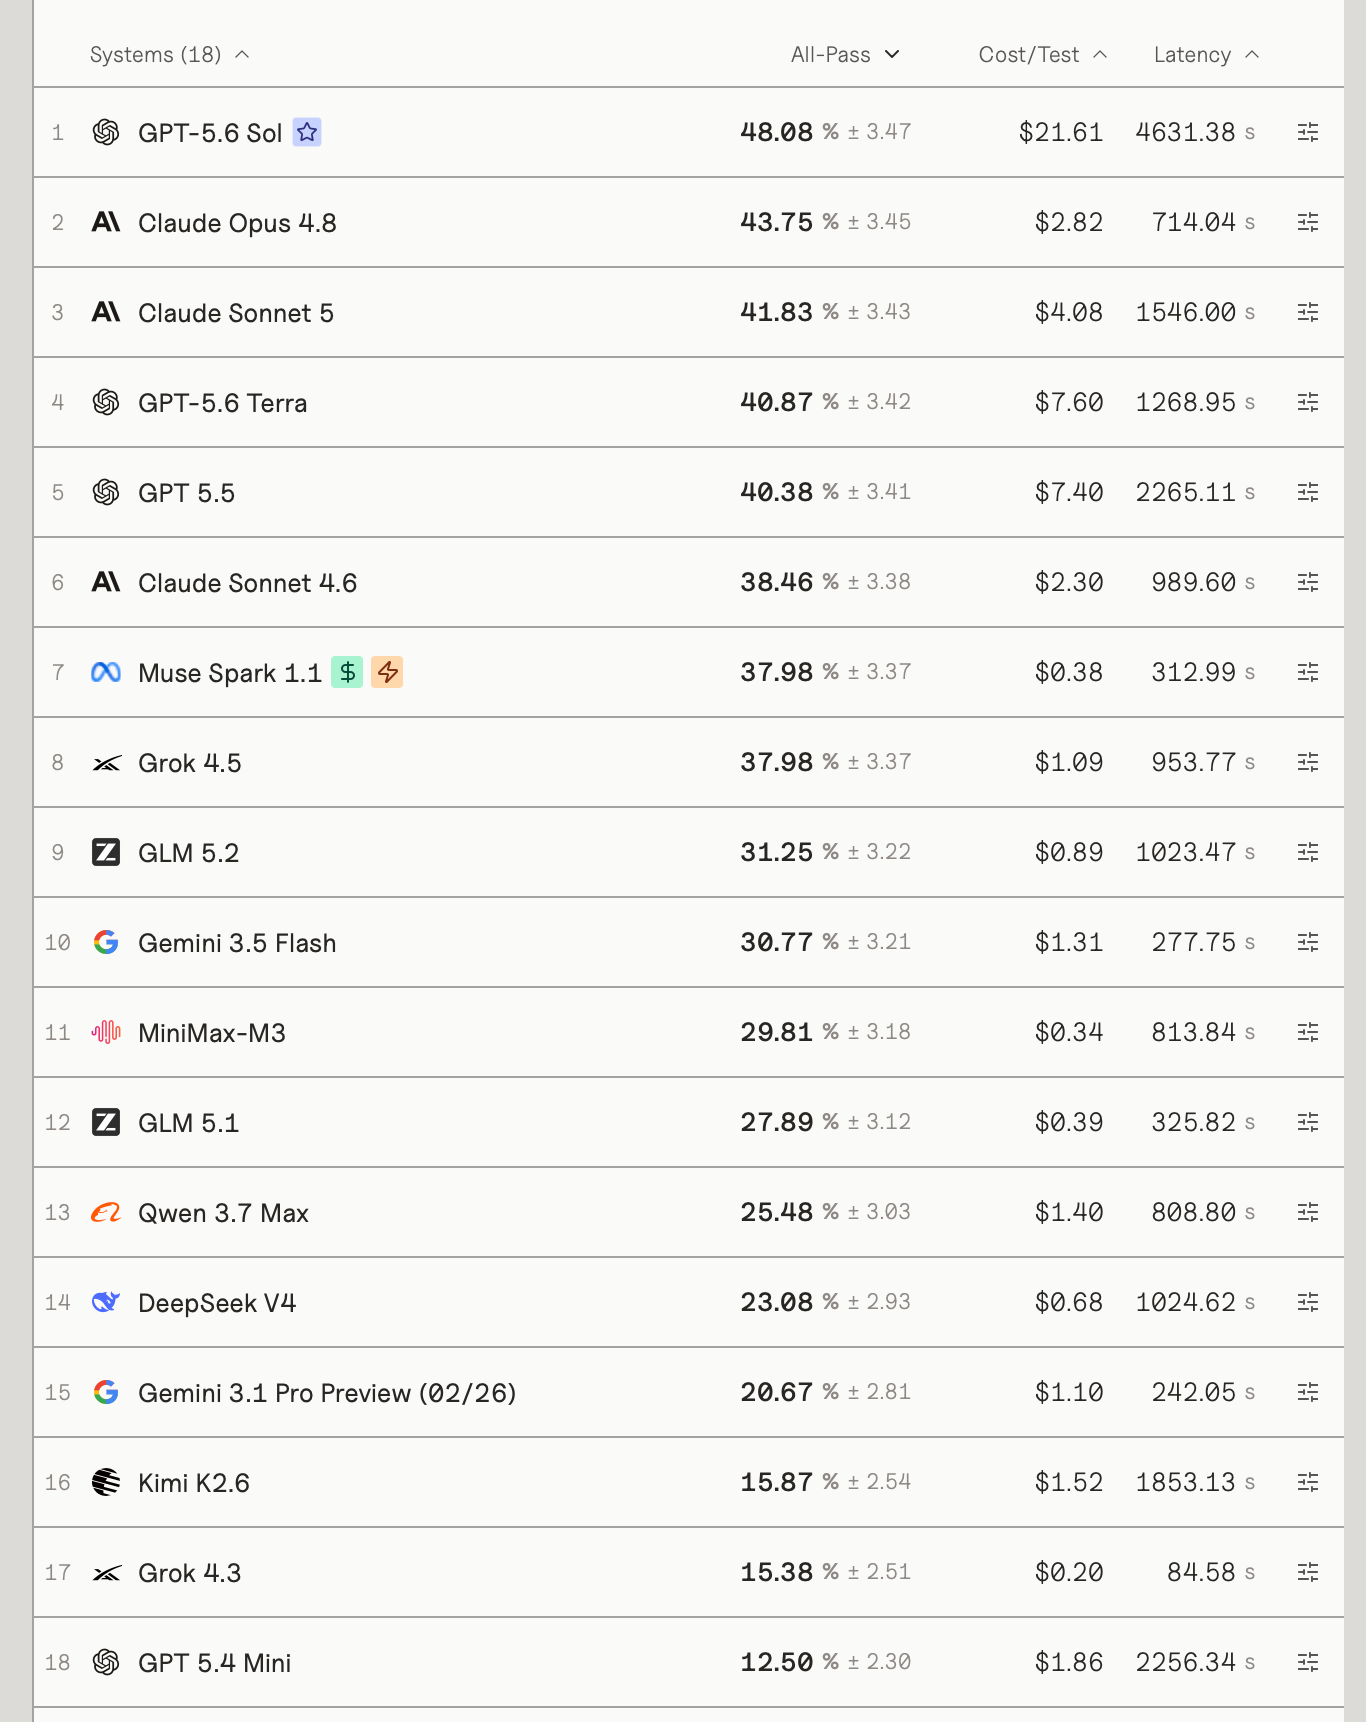
Разница между двумя метриками на одних и тех же ответах: при частичном зачёте топ-модели берут больше 80% weighted. При строгом all-pass ни одна не преодолевает 49%.
Обоснование Vals:
Мы отчитываемся по all-pass как по основной метрике, потому что в юридической работе частично верный ответ может быть опаснее неверного: он читается как надёжный, но упускает критический пункт. Weighted-балл выше 80% может замаскировать, что ответ пропускает обязательный элемент.
Общий уровень all-pass по бенчмарку — 28,4%.
LLM-судья и его валидация
Судит GPT-5.4. Обоснование выбора:
Мы выбрали этого судью, потому что его оценки согласуются с мнением большинства из трёх человек-экспертов лучше, чем с этим большинством согласуется любой отдельно взятый человек-рецензент: GPT-5.4 совпадает с большинством в 87,4% случаев против 83,4% в среднем у человека.
Это корректный способ обосновывать LLM-судью: не «LLM надёжнее человека вообще», а «на этой рубрике и этих задачах его согласие с экспертным консенсусом не хуже, чем у самих экспертов». Величина измеримая, и она опубликована.
Результаты, снимок на 9 июля 2026
Отрасль права как ось отчётности
Задачи покрывают восемь областей: административное и регуляторное право, уголовное, коммерческое, конституционное, здравоохранение, гражданский процесс, семейное, иммиграционное. Но это ось отчётности, а не ось дизайна: по отраслям ничего не строилось, они служат разрезом результатов. Категории не взаимоисключающие — многие вопросы затрагивают сразу несколько областей.
По моделям:
| Модель | Family | Criminal | Civil Lit | Admin/Reg | Health |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 14 | 44 | 41 | 61 | 80 |
| Claude Opus 4.8 | 18 | 46 | 52 | 44 | 53 |
| Claude Sonnet 5 | 18 | 40 | 44 | 55 | 63 |
| GPT-5.6 Terra | 14 | 37 | 33 | 58 | 77 |
| Claude Sonnet 4.6 | 27 | 37 | 30 | 44 | 53 |
Обе модели поколения GPT-5.6 сильны в регуляторно нагруженных областях (80% и 77% в здравоохранении) и слабы в семейном праве — 14%, хуже, чем у Claude Sonnet 4.6 с его 27%.
Vals формулирует это так: сложность области практики и способности модели накладываются друг на друга, и ни один из факторов не перекрывает другой. Семейное право даётся тяжело всем (в среднем ~12% all-pass), а здравоохранение всем даётся легче (~44%). Из этого видно, что отрасль не выравнивает модели. Внутри одного здравоохранения разброс идёт от 17% у слабых моделей до 80% у лидера — то есть шире, чем разброс между средними по отраслям. И при этом общий рейтинг не переносится на отрасль. GPT-5.6 Sol занимает первое место в бенчмарке с 48,08%, но в семейном праве берёт 14% — и проигрывает там Claude Sonnet 4.6, который в общем зачёте шестой, а в семейном лучший с 27%.
То есть в разных отраслях лидеры разные, и порядок в таблице перетасовывается. Отсюда вывод: агрегированный балл не переносится на конкретную практику. «Первое место, 48,08%» не говорит семейному юристу ни какой уровень надёжности его ждёт, ни даже какую модель ему брать.
Двойная разметка вопросов
Каждый вопрос несёт две метки: базовый тип рассуждения, которого он требует, и overlay-флаг — дополнительный источник сложности, который может лечь на любой базовый тип. Вопрос может иметь несколько базовых типов и любое сочетание флагов, включая ни одного.
- Regulatory Framework Interpretation: как подзаконные акты и разъяснения государственных органов реализуют закон и работают вместе. Средний All-pass вопросов с этой меткой: 37,8%
- Statutory Interpretation: значение и смысл текста закона, как его толковали суды. Средний All-pass вопросов с этой меткой: 26,4%
- Doctrinal Rule Reasoning: определить применимый доктринальный тест и правильно применить его к фабуле. Средний All-pass вопросов с этой меткой: 25,5%
- Temporal Validity: ответ зависит от того, действует ли норма и как она менялась. Средний All-pass вопросов с этой меткой: 27,3%
- Reconciliation: требуется синтез через несколько источников: сравнить юрисдикции, сопоставить противоречащие правовые позиции судов, разрешить коллизии норм. Средний All-pass вопросов с этой меткой: 20,7%
Как видно, Reconciliation — самый сложный флаг во всём бенчмарке: 20,7% против 28,4% all-pass в среднем во всём замере. Разрыв держится у каждой модели без исключения: каждая берёт на сложных вопросах, требующих усреднения позиций разных источников, меньше, чем на любых остальных — нет ни одной модели, которая была бы сильна в сведении конфликтующих источников.
Temporal Validity, для контраста, самостоятельным препятствием не оказался: 27,3% — фактически на уровне общего среднего. Понять, действует ли норма до сих пор, модели умеют. Свести вместе источники, которые друг другу противоречат, — нет.
Другое интересное из замера (разверните для деталей)
Vals отчитывается не одной точностью. По каждой модели публикуются стоимость прогона задачи, латентность, число ходов и вызовов инструментов, распределение вызовов по типам инструментов, траектория (в каком порядке модель искала, читала и извлекала), длина ответа и число процитированных источников. Точность откладывается против стоимости и латентности на Парето-графике: видно не только, кто точнее, но и кто точнее за разумные деньги и время.
Эффективность не равна усилиям. Claude Opus 4.8 тратит в среднем 12 ходов и 28 вызовов инструментов на задачу (~$2,82, ~12 минут). Kimi K2.6 — свыше 90 ходов и 100+ вызовов, и берёт 15,87%. На разобранном публичном примере Kimi сделал 174 вызова, в основном веб-поиск, Opus 4.8 — 38. Самая выгодная по деньгам из приличных: GLM 5.2 — 31,25% меньше чем за доллар за задачу.
Перекос в сторону веб-поиска — практики слабых моделей. В среднем по моделям web_search вызывается чаще, чем поиск по судебной практике: 26 вызовов за сессию против 11 у courtlistener_search. Но это именно среднее, а не характеристика каждой модели: Claude Opus 4.8 балансирует практику и веб примерно поровну. Средний перекос создают слабые модели, которые гонят вал запросов — преимущественно веб-поисковых — не конвертируя это в точность.
Длина ответа. Эталонные ответы — в среднем 536 слов; все модели пишут длиннее, Claude Sonnet 4.6 — около 2 300. Самые длинные ответы при этом не самые высокооценённые: рубрика вознаграждает верное и подкреплённое рассуждение, а не объём. То же с источниками: большинство моделей цитируют больше эталонных 6,2, но балл определяется качеством и релевантностью, а не количеством.
Legalbenchmarks.ai
Legalbenchmarks.ai — не компания-оценщик, а сообщество. Первый раз я о нём услышала в канале Хольгера Цшайге и испытала сильную эмоцию: кто-то уже делает то, что хотела бы делать я, что так нужно российскому AI-LT рынку!
Основательница — Анна Гуо; по описанию проекта, она замеряла работу ИИ в реальных юридических воркфлоу вместе с более чем 500 юристами, и эта работа повлияла на сотни закупочных решений. У проекта есть CTO, специалист по AI Trust & Safety, целый консультативный совет из in-house-юристов (Zoom, Morgan Stanley, Henkel, Santander, Franklin Templeton, Razer, Dentsu) и большой комитет из юристов-практиков.
Методология
Основной проект — это лидерборд (последнее обновление — июль 2026, перезапуск ежемесячный). Он строится на 63 задачах, составленных вокруг реальных запросов, с которыми юристы в действительности приходят к ИИ:
- 34 задачи на драфтинг договоров: написать пункт с нуля, отредлайнить чужой драфт, подготовить допсоглашение, собрать соглашение из шаблона, переформулирование текстов.
- 29 задач на извлечение информации: найти в документе оговорку, определение, применимое право, суммы, обязательства. Задачи варьируются по широте вопроса, чистоте документа, числу документов и — существенное — по тому, присутствует ли ответ вообще: есть, отсутствует, частичный или противоречивый.
Ось дизайна — снова сценарий работы, а не отрасль права. Отрасли подсвечены («коммерческое, IP, трудовое, M&A, антимонопольное»), но как оговорка о «смещении», имеющем место в наборе данных, а не как принцип построения. Все задачи одноходовые: одна инструкция, один ответ.
Откуда берутся задачи:
- Авторские задачи от юристов-практиков — ядро набора. Юристы сообщества пишут задачи, инструкции по оценке, референсные ответы на основе реальных сценариев из своей работы.
- Синтетические задачи — но сгенерированные по довольно нетривиальной методике: их не придумывают с нуля, а выращивают из режимов отказа (failure mode), то есть класса ситуаций, где ответ предсказуемо оказывается неверным. Например: модель выдумывает источник; пропускает один из обязательных элементов ответа; превращает условный ответ («да, если соблюдены А и Б») в безусловный («да»).
У Legalbenchmarks было два предыдущих раунда — Phase 1 (извлечение информации: 6 ассистентов на 18 задачах) и Phase 2 (драфтинг: 13 инструментов и человеческий baseline на 30 задачах). В обоих они не только считали баллы, но и разбирали, как именно модели ошибались, и выписывали повторяющиеся способы. Получившийся список режимов отказа стал заданием для генератора задач: построить новые задания, которые целятся ровно в эти уязвимости. Туда же пошли режимы отказа, вычитанные из чужих опубликованных бенчмарков. Каждую сгенерированную задачу перед попаданием в набор проверяет человек-эксперт: машина предлагает, юрист утверждает.
Замер качества
Качество считается по двум независимым осям, которые принципиально не складывают в единый балл:
Reliability — «правильный ли ответ»: точность, полнота, релевантность заданному и честность в отношении того, чего ИИ не знает, вместо выдумывания. Отчитывается как доля задач, выполненных полностью верно, — то есть тот же all-pass.
Usefulness — «можно ли этим пользоваться как есть»: три подбалла (ясность, длина, структура), каждый по шкале 1–3, где 1 — переделывать перед использованием, 2 — пригодно с правками, 3 — использовать как есть. Подсчитывает среднее из трёх.
Как говорят авторы, меморандум может быть технически точным и нечитаемым — или прекрасно оформленным и неверным; раздельная отчётность сохраняет это различие.
Чеклист, который допускает несколько правильных ответов
Это прямой ответ на возражение, которое мне писали в комментариях к #делай_bench, ну и которое очевидно из специфики юридического домена: в праве часто нет единственного правильного ответа, и непонятно, что тогда проверять.
Решение Legalbenchmarks — чеклист требований, который пишет тот же юрист, что составил задачу. Множественность правильных ответов кодируется прямо в чеклисте. Например, юрист поручает ИИ составить заведомо неисполнимый пункт. Критерии написаны так, чтобы засчитать любую из нескольких легитимных форм ответа:
- отказаться составлять и объяснить почему;
- составить запрошенный пункт, но явно пометить риск;
- предложить законную альтернативу с обоснованием замены.
Молчаливое исполнение плохой инструкции засчитывается как fail.
Сравните с первым VLAIR, где отказ Vincent AI отвечать снижал баллы. Здесь принципиальное отличие подхода в том, что чеклист описывает не только правильный ответ, но и запрещённые ходы.
Судьи и их валидация
Reliability оценивает один LLM-судья (Claude Sonnet 4.6) против чеклиста задачи. Usefulness — панель из двух судей (Claude Sonnet 4.6 и Gemini 3.1 Pro), работающих параллельно по каждой ячейке; оценки усредняются в консенсус.
Дальше — две проверки самого судьи.
1. Cross-grader agreement — согласие между судьями. На ~1 700 парных оценках два судьи usefulness дали точно одинаковый балл примерно в 82% случаев. По подкритериям согласие расходится: ясность — около 97%, структура — 83–94%, а длина — всего 56–64%. Ячейки, где судьи разошлись на два и более пункта, уходят на ручной пересмотр.
2. Favoritism check — проверка на кумовство. Проверяют, не завышает ли судья баллы моделям своего же производителя. Судья — Claude Sonnet 4.6; в данных это не проявляется: Sonnet не возглавляет лидерборд usefulness ни в одной категории, а по подкритерию длины модели Anthropic вообще внизу таблицы — противоположность тому, что дал бы предвзятый судья.
Обе проверки методологически несложны и стоят почти ничего. Но без такой обвязки LLM-судья — это просто мнение одной модели о других, и устойчивость этого мнения не известна никому, включая авторов бенчмарка.
Результаты: драфтинг договоров, июль 2026
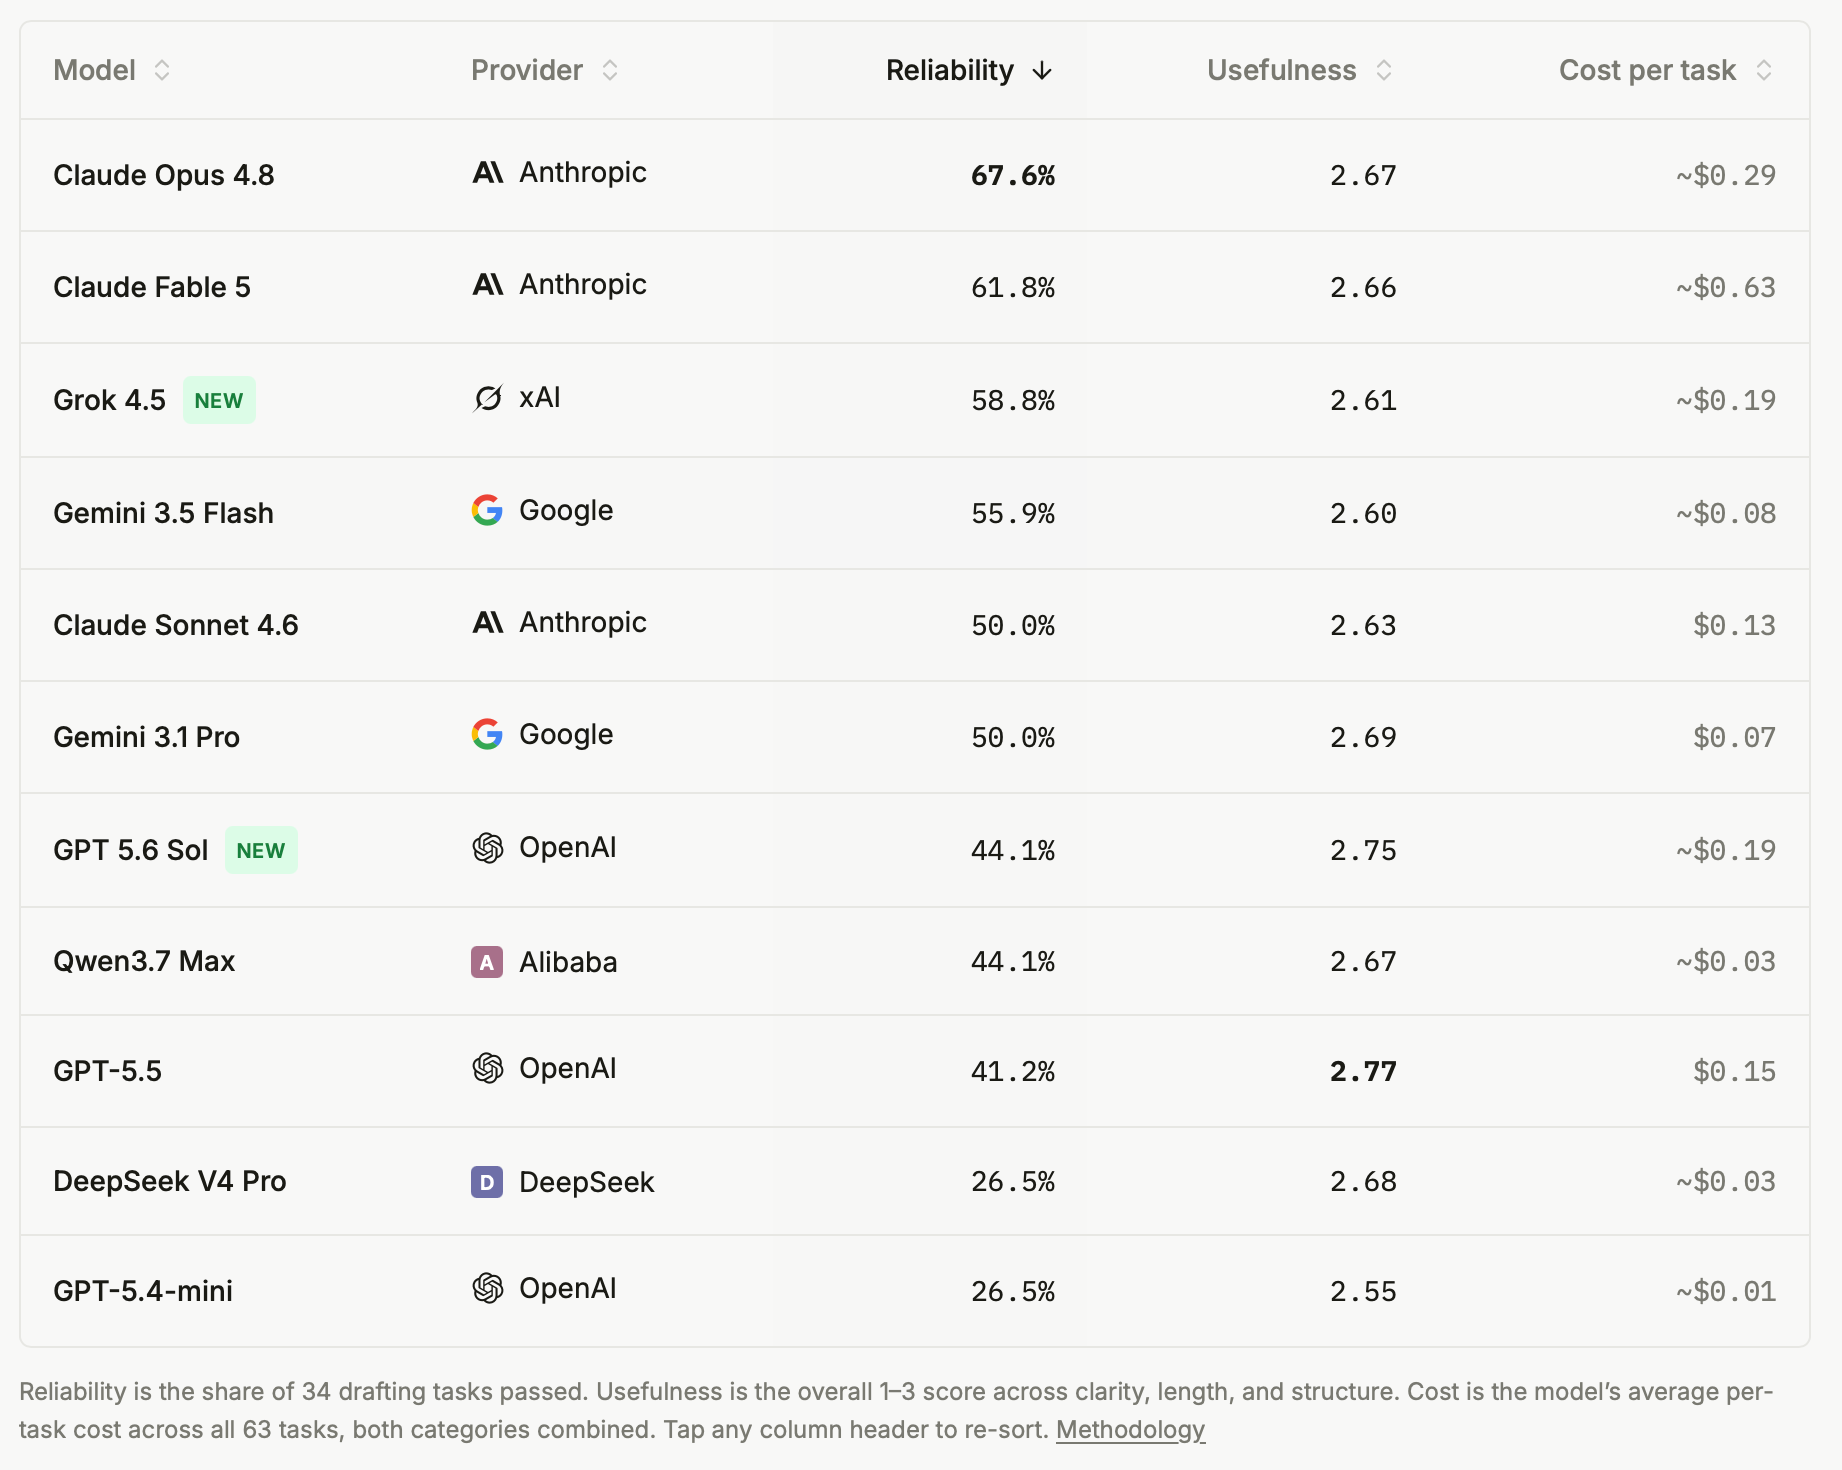
Вывод авторов раунда: ИИ всё ещё недостаточно надёжен, чтобы драфтить договоры без перепроверки. Лидер проваливает примерно каждую третью задачу.
Три наблюдения, ради которых оси и разводили:
- GPT-5.6 Sol драфтит красивее, чем точнее. Наивысшая полезность среди топов (2,75) при 44,1% надёжности. Текст читается чистым и финальным, но более половины его драфтов пропускают минимум одну инструкцию — и эти ошибки легко не заметить именно потому, что драфт выглядит опрятно. Единый балл такое расхождение не позволил бы заметить.
- Grok 4.5 — единственная модель, которая последовательно распознавала, что существующая формулировка уже нормальная, и не трогала её. Не редактировать то, что не надо редактировать, — отдельная способность.
- Конфликты остаются общей слабостью поля. Там, где инструкции противоречат исходным документам или друг другу, большинство моделей драфтят сквозь противоречие, а не поднимают его. Лучше всех эти случаи отработал Opus 4.8; GPT-5.6 Sol чаще прочих продолжал драфтить, не отметив проблему.
Ограничения бенчмарка
- 63 задачи, смещение в коммерческое, IP, трудовое, M&A, антимонопольное; только английский язык, уклон в США и Великобританию.
- Только одноходовые задачи. Многоходовые воркфлоу, длинные дела, итеративная доработка не тестируются — «а это ближе к тому, как юристы реально используют эти инструменты».
- LLM-судьи валидируются людьми выборочно, а не по каждой задаче.
- Системные промпты стандартизованы: модель, которая выиграла бы от более тонкого промпта, здесь выглядит слабее, чем на практике.
- Консистентность и дрейф не тестируются: один прогон на задачу. Насколько выход модели гуляет при повторных прогонах одного и того же задания, не измеряется.
Сам набор задач, референсные документы и покритериальные чеклисты не публикуются: полная публикация позволила бы вендорам подстраиваться под бенчмарк. Исследователи могут запросить доступ к методологии, вендоры — прислать свой инструмент на прогон по тем же задачам.
Источники
- Vals AI — методология и устройство наборов данных
- Vals AI — VLAIR, февраль 2025
- Vals AI — VLAIR: Legal Research, октябрь 2025
- Vals AI — Legal Research Bench; харнесс и публичные образцы на GitHub
- Legalbenchmarks.ai — лидерборд и методология; о проекте
- Evan Miller, Adding Error Bars to Evals
- Bob Ambrogi (LawSites), разбор VLAIR: Legal Research
- Artificial Lawyer, публикация первого VLAIR и комментарий LexisNexis
Даты снимков: Vals Legal Research Bench — 9 июля 2026; Legalbenchmarks — июль 2026. Оба обновляются: Vals — по мере выхода моделей, Legalbenchmarks — ежемесячно.