Legal AI Benchmarking: как это делать здесь? Часть 3: методика
Методологический обзор компонентов хорошего бенчмарка: задачи, оценки, публикация результатов, обсуждение «бутылочных горлышек» бенчмаркинга в юридическом домене.
На российской AI LegalTech полянке наметилось несколько субъектов, задумывающихся о бенчмаркинге. Задача эта сильно сложнее, чем может казаться издали: бенчмарков же полно всяких, ну и чего юристы свой не сделают?
Я немало изучала западный опыт, немало делала на этом поприще уже и сама, в том числе непублично, и надеюсь этим постом агрегировать свои исследования и опыт, чтобы с одной стороны подсветить все точки напряжения, делающие эту задачу сложной, а с другой — всё-таки дать сообществу методологический фреймворк-конструктор. Наблюдателям и потенциальным покупателям ИИ-сервисов — ориентир, что считать хорошим бенчмарком, которому стоит доверять.
Я планировала всего три части этого цикла, по дороге он оброс четвёртой (замером качества поиска информации), но по итогу будет не меньше пяти. А всё потому, что показалось недостаточным опубликовать этот конструктор-методичку и пожелать всем желающим делать бенчмарки доброй охоты. Есть некий слон в комнате, который я пока назову «институциональным срезом», и о нём будет следующая часть цикла.
Содержание
- 1. Объекты замеров
- 2. Задачи (то есть сам бенчмарк)
- 3. Построение рейтинга
- 4. Протокол и публикация
- 5. Вы уже поняли, почему бенчмаркинг — это дорого?
- 6. Поле вариантов
- И напоследок: что меняется, если бенчмарк внутренний
1. Объекты замеров
Когда я делала свой беби-бенч, то получила много вопросов о том, почему этот сервис выбрали, а тот — нет? Этот вопрос обязательно будет волновать ваших конечных потребителей, поэтому необходимо обоснование выбора участников замера.
В российских реалиях выбор конкретных наименований несколько проще, чем у коллег на западе: сервисы могут отозвать своё участие, некоторые сервисы запрещают на уровне пользовательского соглашения использование продукта для целей бенчмаркинга. Но я в целом предлагаю поговорить не о названиях, а о классах: наш рынок так устроен, что некоторые вещи о нём следует понимать на берегу.
Продукт как чёрный ящик
Vals, о котором я писала ещё в первой части цикла, за полтора года прошёл путь от сравнения продуктов-сервисов к сравнению моделей в одинаковой агентной обвязке. Вендоры отказывались участвовать, а использование LLM по API ничьего согласия не требует.
В России подавляющее большинство сервисов — это не агентные харнессы вокруг известных LLM, а более простые пайплайны: RAG по какому-то корпусу данных либо API известной СПС, экспертный системный промпт, возможно, какие-то чек-листы или шаблоны документов. Модель под капотом почти никто не раскрывает, а те, кто раскрывают, чаще всего дают пользователю выбирать её самому.
Если продукт не раскрывает, какая модель у него внутри, его результат невоспроизводим. Вендор может сменить модель под капотом молча, и продукт станет неузнаваемым, с совсем другим качеством. И произойти это может буквально на следующий день после вашего замера. В любом бенчмарк-отчёте это должно быть обозначено как ограничение и констатация, что он валиден буквально на такой-то час такого-то дня.
Нельзя выкидывать «обычные нейросети» из замера
Огромное количество людей решает юридические задачи не в специализированном сервисе, а в сервисах, которые делают вендоры крупнейших LLM: просто в браузере с ChatGPT, Claude и так далее. И сакраментальный вопрос, которым может задаться потенциальный покупатель, звучит даже не «какой сервис лучше», а «есть ли вообще смысл платить за специальный, если задачу неплохо решает обычный чат». Бенчмарк, который не адресует этот вопрос, — это маркетинговый инструмент.
Разница между обычной нейросетью и специализированным сервисом проявляется на определённых аспектах. Так, например, что во втором замере Vals по правовому исследованию ChatGPT показал по точности 80% — вровень с юридическими сервисами (78–81%) и заметно выше живых юристов (71%). Разница обнаружилась не в точности, а в авторитетности источников: 76% у юридических ИИ против 70% у ChatGPT. Если бенчмарк подсвечивает эту разницу аспектов, то тогда сообщество получает ответ, за что ему предлагается доплачивать. Аспекты подробнее рассматриваю далее. Кроме того, включение обычных LLM в замер становится полезным для тех продвинутых пользователей, что используют харнессы, и для разных агентов-персон используют разные LLM.
Из этих наблюдений следуют практические выводы, которые следует учитывать при проектировании замера. Кроме исследования отдельных аспектов, нужно планировать классы задач, решаемые в принципе без доступа к закрытым базам (иначе сравнение нечестное), и класс задач, где без базы никак.
2. Задачи (то есть сам бенчмарк)
Очевидная в целом мысль, но её хочется артикулировать: бенчмарк способен сказать что-то только про те задачи, которые в него явно включены. Узко определённый набор не просто ограничивает выводы, а может вводить в заблуждение, умалчивая о способностях сервиса, не покрытых вашим набором задач. Поэтому предлагаю при составлении наборов учитывать то, что разобрано далее, чтобы даже достаточно компактный сет вопросов покрывал то, что наиболее востребовано рынком.
2.1. Основа дизайна: Q&A по отраслям vs сценарии и кейсы vs практики
Первое решение, которое вы принимаете, — о принципе построения задач в наборе. В разобранных мной бенчмарках видно три принципиально разных подхода.
Вопросы по отраслям права. Велик соблазн придумывать задачи именно так. Так устроено юридическое образование, и это сказывается на образе размышлений большого количества юристов о праве и на их самоидентификации в профессии. Этот подход, скорее всего, будет реализован в тех бенчмарковых проектах, которые будут появляться. И именно так обычный пользователь-юрист представляет себе тестирование модели — набор вопросов по своей отрасли с какими-то ожидаемо правильными ответами.
Это всё близко к типичному экзамену, привычной юристу форме проверки знания. Это достаточно простой способ делать бенчмарки, и это неплохая точка для старта. Но на западе разобранные мной бенчмарки преимущественно устроены не так.
Сценарии работы. Три из четырёх продуктовых и агентных замеров строятся вокруг них.
Примеры таких замеров:
- Vals в первом VLAIR это семь типов задач: извлечение данных, вопросы к документу, суммаризация, редлайн, анализ транскриптов, построение хронологий, поиск по EDGAR;
- Legalbenchmarks — драфтинг договоров и извлечение информации;
- Thomson Reuters в CoCoBench — research, drafting, review и многошаговое рассуждение.
Практики юридической фирмы. Особняком стоит Harvey. В LAB задачи распределены по типичным 24 видам практик. Практики — это не отрасли права. Это то, как называются практики в юрфирмах, вроде Data Privacy and Cybersecurity или International Trade and Sanctions, то есть способ фирмы обозначить тип работы для типа клиента. Логика выбора понятна из того, зачем LAB сделан: он адресован крупным фирмам и задуман как руководство для решений о внедрении и расчёта отдачи от вложений в ИИ. Фирма внедряет ИИ по практикам как своим структурным элементам с отдельными бюджетами и партнёрами, поэтому ось следует за оргструктурой покупателя.
Таксономии непосредственных сценариев работы в отчёте нет. При этом авторы в том или ином виде признают важность сценариев: например, обращаю внимание на то, что многие типы задач внутри практик остались непокрытыми. И при комментировании результатов они всё равно скатились к сценариям: причины неравномерности (jagged intelligence) объясняются именно через сценарий работы — где-то решает поиск и исследование, где-то синтез и аналитика, где-то структурное сопоставление с нормами.
Почему мне ближе сценарии:
- Разброс внутри одного продукта по сценариям может быть очень большим. По результатам первого VLAIR Harvey получал 94,8 на вопросах к документу и 65,0 на редлайне. Сказать «этот сервис хорош» без указания сценария невозможно.
- «Знание» сервисом какой-то отрасли права технологически обеспечивается, по сути, известной читателям моих ресурсов технологией из трёх букв (если кто-то подумал про другие три буквы, то я имела в виду RAG). Да, там можно соревноваться по качеству подготовки данных и точности поиска... поэтому получается, что знание отрасли — это, по сути, реализация сценария поиска. Зачем ограничивать бенчмарк одним сценарием, если у юристов востребовано их гораздо больше?
- Собирать экспертов по сценариям проще. Попросите юриста «напишите задачу по драфтингу из своей практики» — он напишет её из своей отрасли, и отрасль (и даже не одна) придёт в комплекте.
- У всех сервисов разный темп и тактика формирования корпусов данных. Ограничивая себя отраслью права, вы ограничиваете себя в выборе объектов для сравнения.
- Большинство реальных задач всё равно межотраслевые, особенно те, что касаются административно-регуляторной плоскости (как внутри неё вообще делить по отраслям? Как-то можно, и это «как» каждый сервис будет решать для себя по-разному). Решать процессуальные задачи в отрыве от материальных норм тоже странно. И так далее.
- Парадигма отрасли загоняет в Q&A рамку, то есть проверку чисто «знаниевых» вопросов, которые в большинстве случаев юристы либо и так знают, либо быстро по паре норм могут освежить. Чисто вопросный сервис — это сервис для студентов, у реального юриста задачи сложнее, запросы к LLM выше. Поэтому сценариевый подход к замеру — это ещё и отражение того, как сегодня вообще должен строиться юридический ИИ-сервис: не как справочник, отвечающий на вопросы, а как исполнитель работы.
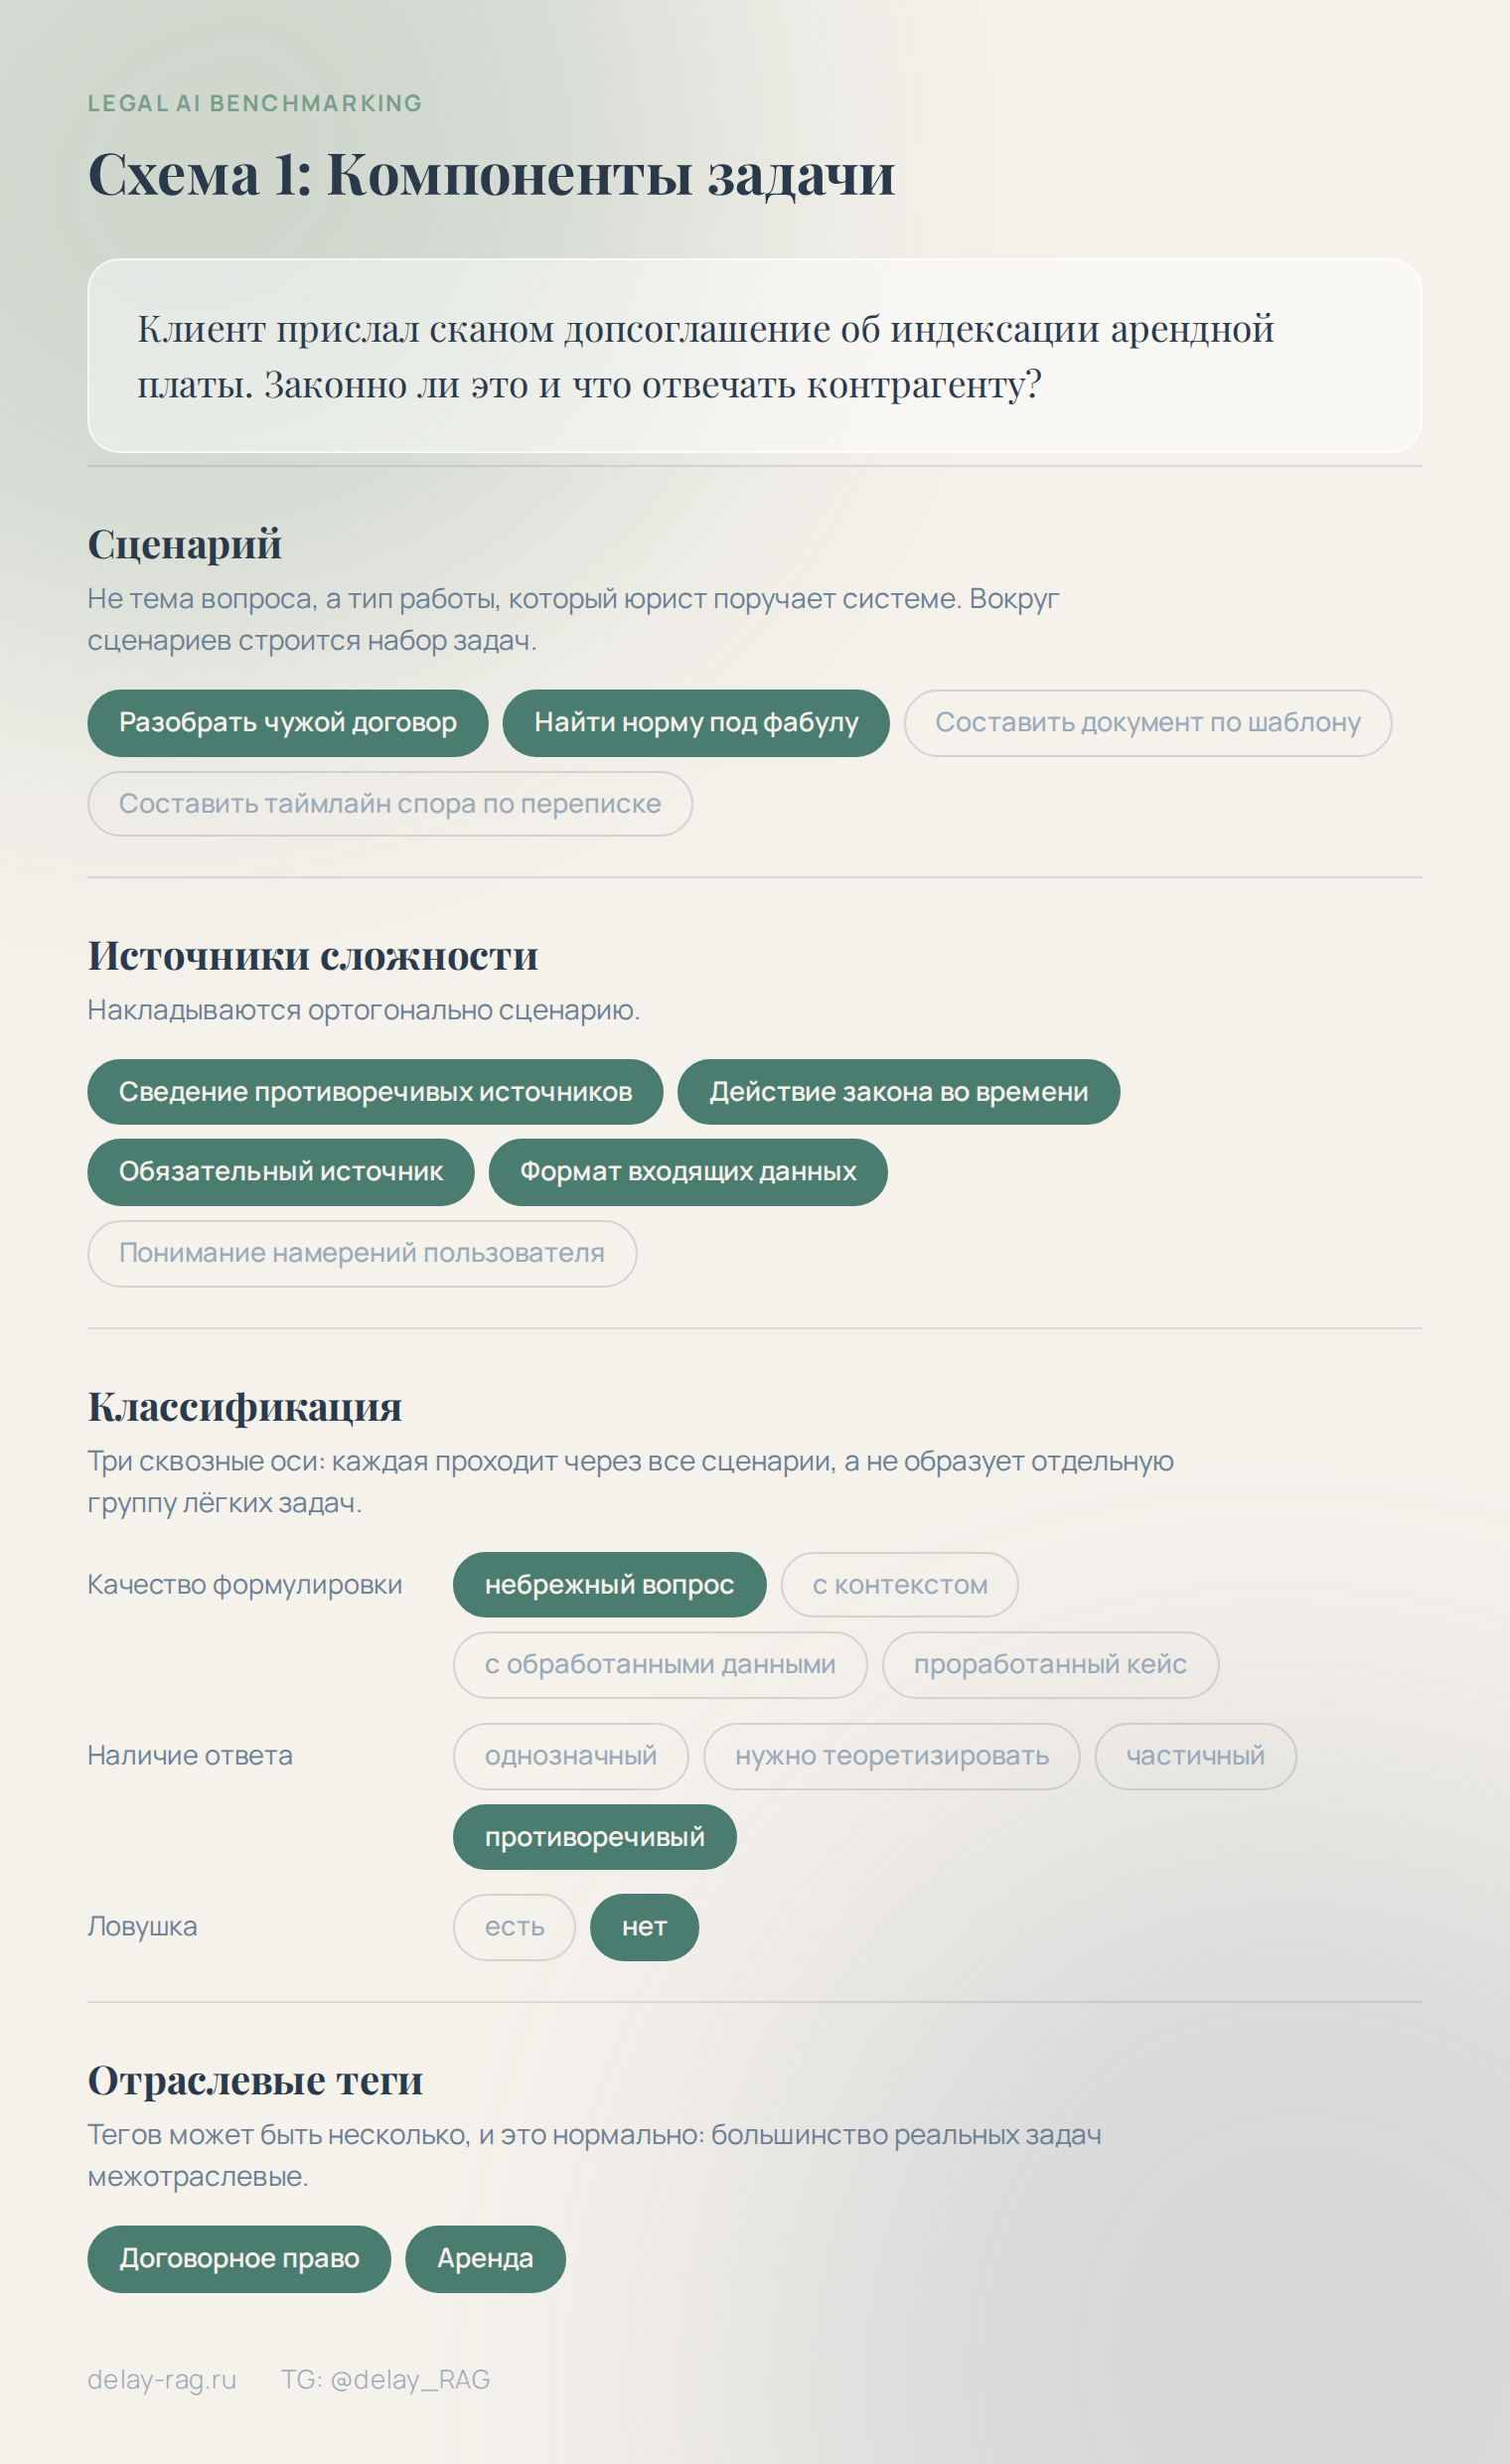
Отрасль при этом не нужно выкидывать из замера (тем более что она всё равно всегда в любом случае будет). Отрасль можно ставить как дополнительный флаг к вопросу, точнее, может получиться несколько флагов: абсолютно нормально, когда для одной задачи стоит несколько отраслевых тегов. В отчётах с результатами можно делать графики с выбором по этим тегам, выдавая пользователям информацию о рейтинге сервисов по этим сферам права.
Как выбирать?
Разница между тремя подходами — не в том, какой из них методологически лучше, а в том, кому адресован результат. Harvey меряет по практикам, потому что его читатель — фирма, которая раскатывает ИИ по подразделениям и считает ROI. Vals и Legalbenchmarks меряют по сценариям, потому что их читатель выбирает инструмент под задачу. Отраслевые вопросы меряют знание, и адресованы они тому, кто проверяет эрудицию, кому нужен усиленный Google в миксе с СПС. Такой уровень использования нейросетей принято считать начальным.
2.2. Источники сложности
Одного сценария мало. Задача «составить пункт договора» может быть тривиальной, а может быть и очень сложной, и сценарий этого не объясняет. Поэтому на архитектурную базу ортогонально накладываются аспекты сложности: что именно делает задачу трудной?
Какие есть варианты:
1) Сведение противоречивых источников. В западных бенчмарках этот параметр называется reconciliation. Vals помечает некоторые вопросы флагом Reconciliation, и у задач с таким флагом уровень all-pass ниже, чем в среднем по бенчмарку у всех моделей без исключения.
Речь о вопросах, где ответ нельзя просто взять по кусочкам из источников: правовые позиции разных относимых к задаче источников могут расходиться, как в нюансах, так и принципиально. Разные суды сказали по-разному, разъяснение ведомства не совпадает с указанием закона, два режима регулирования в коллизии — и юристу при решении задачи нужно находить способ всё это между собой поженить в наилучших интересах заказчика. Мне кажется, что для России это очень актуальный параметр для отдельного отслеживания.
2) Действие закона во времени. Для правильного решения задачи нужно перепроверить неочевидные вещи: действует ли норма, в какой редакции, применима ли эта редакция к спорным отношениям. У нас законодательство меняется быстро, иногда радикально, аккуратная работа с версиями — это известное ограничение RAG-систем. Вопрос «какая редакция действовала на дату спорных отношений» — самостоятельный класс задач-убийц.
3) Обязательный источник. Во многих задачах и областях права есть «те самые» правовые позиции, которые знает любой практикующий в этой области права юрист. И это не всегда даже постановление Пленума, часто может быть какое-то определение экономколлегии, отказное определение Конституционного суда, письмо ведомства, которое не является нормативным актом, но которым все руководствуются. У таких актов есть свои кодовые наименования («дело Мамичева»), и далеко не всегда нейросети понимают, о чём речь. То есть у задач с таким флагом должен быть список обязательных к упоминанию приоритетных ключевых источников.
4) Формат входящих данных. Сканы, таблицы, многостраничные приложения, выписки, договоры с допсоглашениями. Бесшовность работы с ними — вполне измеримое свойство, имеющее огромную ценность для юристов, не желающих разбираться в том, как им свою страшную выписку ЕГРН по МКД конвертировать в Markdown. Legalbenchmarks отправляет документы моделям в нативном виде намеренно, считая чтение файла частью проверяемой способности.
5) Понимание намерений пользователя. Продвинутые пользователи нейросетей делают немало предварительной работы для того, чтобы получать приемлемый для себя результат: обвешивают своих агентов скиллами, грамотно проектируют рабочее пространство, чётко ставят задачи и так далее.
Добавленная ценность сервиса состоит в том числе в том, чтобы эту нагрузку с пользователя снимать, и выдавать рабочие ответы даже по малосвязным написанным с ошибками промптам с пачкой сырых документов. То есть важно определять, умеет ли система квалифицировать тип входящего запроса, достраивает ли она контекст, переспрашивает ли, когда данных не хватает.
2.3. Классификация
Из предыдущего пункта следует, что задачи нужно формулировать по-разному, и эта разность может складываться из трёх аспектов:
- Качество формулировки задачи: от небрежного вопроса, как его задал бы неподготовленный пользователь, до проработанного кейса с приложенными обработанными данными, структурированным контекстом и чёткими требованиями к ответу.
- Наличие ответа в доступных источниках (и в целом доступность источников). Есть однозначные и легко отыскиваемые ответы, нет никаких ответов и нужно теоретизировать, ответы есть частично или в закрытых базах, ответы противоречивы.
- Ловушки. Ложная посылка в вопросе, когда в самом вопросе утверждается несуществующая норма или не соответствующие реальности факты.
Обобщим всё вышесказанное на наглядной картинке!
2.4. Откуда берутся задачи и эталонные ответы
Возможны примерно три источника:
1) Основной и очевидный: от практикующих юристов. Юристы сообщества или привлечённые за плату консультанты пишут задачи, инструкции по их решению, составляют референсные файлы и критерии оценки качества ответов на основе реальных сценариев из собственной работы. Это самый дорогой и сложный вариант.
2) Синтетические вопросы, составленные из провалов предыдущего раунда (или вашего собственного сервиса, если вы вендор). Так бенчмарк учится на собственных находках. Эта идея от Legalbenchmarks, и у них каждую такую синтетическую задачу до включения в набор валидирует человек-эксперт. Можно, конечно, и чисто синтетические задачи генерировать, но мне этот путь кажется самым неудачным: всё равно должны прийти, как минимум, вдохновение и идеи от реальных практиков.
3) Уже существовавшие эталоны. Речь о уже кем-то ранее собранных ground- truth-ответах на какие-то вопросы. Эти вопросы и ответы должны быть собраны не с целью прогоняться через ИИ и не должны быть опубликованы ранее (иначе они уже могли попасть в RAG-базы, обучающий корпус подкапотной LLM, или умеющий ходить в Интернет сервис их быстро отыщет).
Второе условие отсекает большую часть очевидных кандидатов. Опубликованные обзоры практики, открытые справочники, всё, что лежит в вебе, — такие наборы ждёт судьба LegalBench: датасет открыт с 2023 года и лежит на Hugging Face, поэтому отличить рассуждение от запоминания на нём больше нельзя.
Остаются авторские и консультантские неопубликованные материалы и методички, индивидуальные разъяснения госорганов на частные запросы, внутренние справочники и разборы компаний, совсем-совсем свежие материалы.
2.5. Эталон бывает неверен
Среди одиннадцати принципов Thomson Reuters есть такой: проверять, не ошибочен ли сам эталонный ответ, потому что бывало, что ИИ прав, а эталон неверен.
В одном из академических замеров (прямые цитаты не могу приводить по причинам, по которым не освещаю академический бенчмаркинг в целом) сравнивали, как коммерческие юридические системы и академический инструмент справляются со сводными обзорами законодательства пятидесяти штатов. Эталоном был LaborBench, построенный на компиляции, которую составляют юристы Министерства труда США: многомесячная ручная инвентаризация требований законодательства о страховании от безработицы по всем штатам. Когда исследователи вручную проверили расхождения между инструментом и эталоном, оказалось, что значительная часть — не ошибки инструмента, а ошибки в ответах, подготовленных юристами Министерства. С поправкой на это точность академического инструмента поднялась с 83 до 92%.
Практический вывод в том, что разница между ответом ИИ и эталоном — это не всегда ошибка системы. Её можно интерпретировать как расхождение, и если этого не делать, то есть риск необоснованных штрафов сервису за то, что он нашёл больше эксперта. Чтобы этого избежать, нужны протоколы проверки эталонов и анализа ложноположительных результатов в ответах от ИИ-сервисов.
3. Построение рейтинга
Задачи собраны! Теперь надо решить, кто и как будет оценивать ответы — и это, конечно, самая сложная и потенциально спорная часть.
3.1. Кто судит
Можно выстроить спектр от чисто человеческой оценки (human eval) до чистого LLM-as-a-judge. На этом спектре по результатам моих предыдущих обзоров обозначились пять подходов:
1) Во втором VLAIR автоматической оценки не было вообще: из-за вариативности правильных ответов на исследовательский вопрос оценивала вслепую группа юристов и правоведов, минимум два оценщика на ответ, нулевые баллы перепроверял третий.
2) В первом VLAIR судила LLM, но проваленные ответы дополнительно перепроверяли вручную; Vals там прямо оговаривает, что ручная оценка всех выходов заняла бы у одного человека больше 400 часов.
3) Legalbenchmarks судит моделью с выборочной человеческой валидацией и эскалацией расхождений.
4) Harvey в LAB прогоняет оценку многократно по разным семействам моделей и усредняет.
5) Thomson Reuters итеративно калибрует промпт судьи, пока его оценки не сойдутся с оценками юристов-экспертов.
Определение какой-то точки на этом спектре — это поиск баланса между стоимостью оценки и доверием к её результатам. Не буду вдаваться в то, насколько труден менеджмент даже тех оценщиков, которым платят, что уж говорить о волонтёрствующих участниках. С другой стороны LLMaJ даже сегодня, в эпоху мультиагентных систем и сильнейших моделей, надёжны на коротких и ясных ответах и очень ненадёжны на длинных. Выход из этого — используемые в Harvey LAB рубрики, то есть атомарные бинарно проверяемые утверждения, извлекаемые из развёрнутого ответа на задачу.
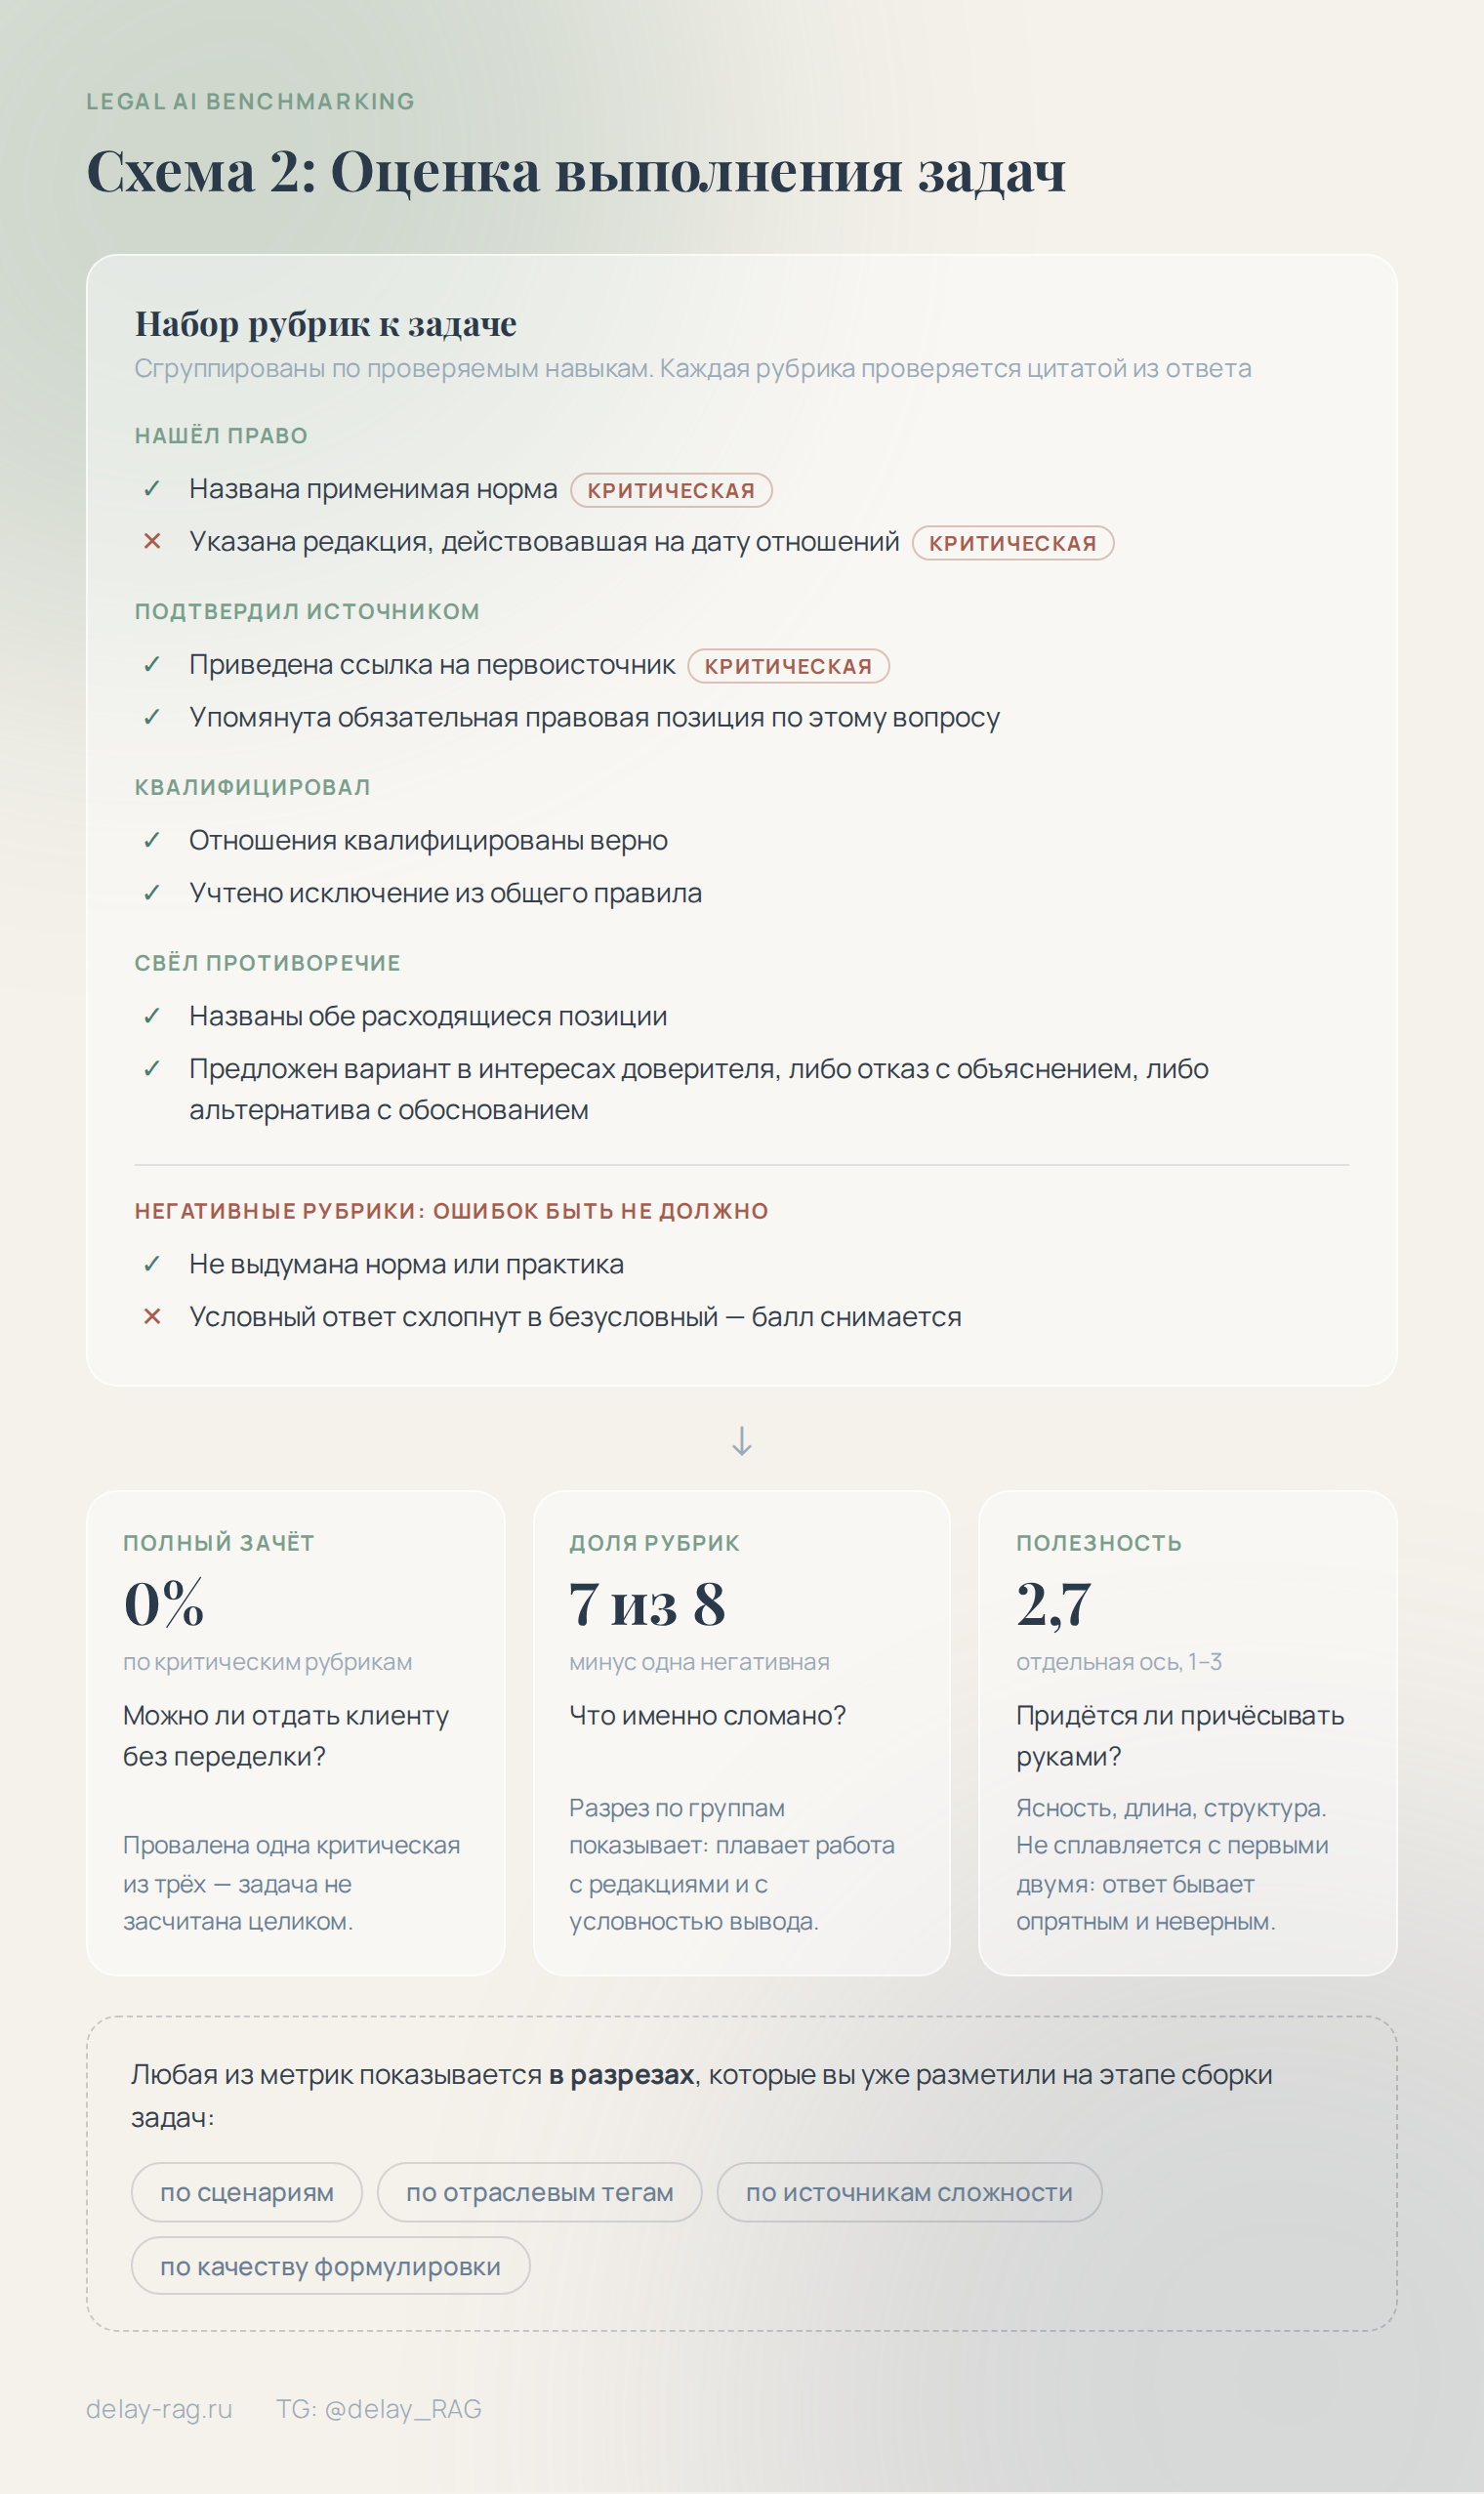
От LLMaJ больше не требуется вынесения суждений о качестве ответа, они только проверяют, есть ли в ответе конкретный элемент. Поэтому качество судьи зависит не столько от того, насколько сильная LLM под капотом у судьи, сколько от качества рубрик. Если критерий сформулирован как «адекватно ли оценён риск», судья снова начинает угадывать. Любая рубрика должна буквально проверяться цитатой из ответа.
3.2. Откуда взялись рубрики?
Узнав о Harvey LAB, я честно думала, что рубрики придумали в Harvey, но потом что-то меня заставило засомневаться, и не зря.
Оказалось, что рубрика как инструмент оценки — из педагогики и психометрики, и ей десятилетия. Разложить сложную работу на отдельные проверяемые критерии, оценить каждый и агрегировать — чаще всего рубрики применяются для проверки открытых заданий (где человек пишет развёрнутый ответ, эссе или решает задачу), чтобы свести к минимуму субъективность проверяющего. Литература о надёжности и валидности рубрик писалась задолго до любых языковых моделей.
LLM-судья как метод оформился в 2023-м, вместе с MT-Bench и Chatbot Arena. Дальше несколько команд почти одновременно поняли, что холистический балл от судьи бесполезен — он не объясняет сам себя и не годится для диагностики, — и начали разбирать оценку на измерения. LLM-Rubric дал многомерный калиброванный подход, который в обзорах называют основополагающим для всей рубричной линии. BigLaw Bench Harvey вышел в конце августа 2024 года, и уже с рубриками, взятыми из общего ML-поля. В соседнем медицинском домене то же самое было сделано позже, в мае 2025-го, когда 262 врача написали рубрики к пяти тысячам диалогов в HealthBench.
Полезным практическим выводом мне здесь кажется то, что юристам-бенчмаркерам не стоит пренебрегать обращением к ML-аналитикам: у профессионалов уже есть богатый инструментарий, и нам следует не изобретать велосипеды, а тюнить имеющееся под особенности домена.
3.3. Второй способ: попарное сравнение
У рубрики есть альтернатива — попарное сравнение. Вы показываете эксперту два ответа на одну задачу и спрашиваете, какой лучше. Из множества таких выборов строится рейтинг. Никаких критериев, никаких баллов — только предпочтение.
В мае 2026-го вышла работа, на которую я не могу сослаться напрямую по всё тем же «нежелательным» причинам, где к 30 юридическим задачам сгенерировали по три ответа заведомо разного качества и дали одни и те же выходы 51 практикующему юристу со стажем от 3 до 35 лет, а также LLM-судье. Каждый оценивал и по рубрикам, и попарно. Выяснилось, что при оценке двух ответов похожего уровня качества (не «отличный против ужасного», а «хороший против чуть менее хорошего») оценивающий по рубрикам расставит их в правильном порядке примерно в 57% случаев — то есть чуть лучше, чем подброс монетки. А если два ответа сравниваются между собой, то они корректно ранжируются в девяти случаях из десяти.
Если брать не пару, а все три уровня, то попарное сравнение воспроизводит заложенный авторами порядок качества почти идеально, а рубричные баллы — практически никак. И то же самое верно для LLM-судьи: на рубриках он не просто ошибается, а выстраивает уровни в обратном порядке.
Вдобавок попарное сравнение вдвое быстрее: около двух минут на задачу против пяти у рубрики. При том, что экспертное время — это самая дорогая часть любого бенчмарка. Кроме того, попарное суждение плохо масштабируется на регулярный лидерборд. Каждая новая система требует сравнений со всеми уже измеренными; число сопоставлений растёт квадратично. Рубрика линейна: прогнали новую модель против фиксированных критериев — получили её балл.
Также попарное сравнение, показывая, что какие-то ответы лучше, не объясняет, почему, а рубрика показывает. То есть рубрики — ценный аналитический инструмент. Как минимум, внутренние замеры должны строиться с их использованием.
Я вижу попарное сравнение прежде всего как оптимальный способ организации human eval-ов: там, где вы всё равно платите за экспертное время, оно вдвое дешевле рубрики и даёт более достоверное ранжирование. А рубрику — как основной инструмент автоматизированной части замера, потому что только она даёт диагностику слабых зон инструмента, и вообще адаптирована именно для LLM.
3.4. Как составлять рубрики
По четырём ключевым правилам:
- Одна рубрика = один атомарный аспект правильного и полезного ответа, подтверждаемый текстом эталона.
- В рубрику включается только то, что правильный и полезный ответ обязан содержать, то есть не nice-to-have бантики. При этом внутри критерии нужно делить по уровню критичности их соблюдения (например, ошибки форматирования в файле с драфтом документа — некритично).
- Должно быть учтено несколько правильных форм ответа. Это ответ на главное возражение, которое выдвигается юристами: в праве редко бывает единственный правильный ответ. Возражение справедливое, и рубрикация по вариантам его закрывает.
- Должны быть негативные рубрики, в которых описываются типичные или наиболее вероятные ошибки. Если эта рубрика выполняется (то есть ошибки нет), балл не добавляется. Если ошибка есть — балл снимается.
3.5. Валидация судей
Даже с рубриками полностью доверять LLMaJ нельзя без мер контроля. Из опыта западных бенчмарков можно выловить несколько рецептов:
- Замер согласия с экспертами. Vals предлагает проводить сравнение: судья согласен с большинством из трёх экспертов чаще, чем с этим большинством согласен отдельно взятый эксперт.
- Согласие LLM-судей между собой плюс проверка на «кумовство» (Legalbenchmarks). Подсчитываете, как часто два судьи дают одинаковую оценку, и отдельно проверяете, не завышает ли судья баллы моделям своего же производителя (здесь учитываем, что у российских сервисов подкапотные модели почти никогда не известны).
- Итеративная калибровка (Thomson Reuters). Промпт судьи дорабатывается, пока его оценки не сойдутся с экспертными.
Также при смене модели-судьи разумно делать перекалибровку. Иначе дрейф судьи может сказаться на качестве его оценок сервисам, и это может быть неверно воспринято как изменение качества сервисов.
В том, что касается human eval-ов, полезно помнить о том, что люди-эксперты между собой расходятся очень часто и сильно. Thomson Reuters называет около 25% на сложных ответах; в GDPval согласие экспертов-оценщиков между собой — 71%, то есть в 29% случаев они расходятся. Для усреднения и выяснения статистической значимости мнений экспертов нужно приложить недюжинные усилия, и я не делала их предметом этой работы. Это психометрическая задача, а я всё ещё травмирована этой историей.
3.6. Сколько раз спрашивать?
Это хитрый вопрос, потому что на самом деле это два разных вопроса. Первый: сколько раз в рамках прогона повторить одну и ту же задачу, чтобы понять, насколько стабилен сервис, то есть не отвечает то с ошибками, то без ошибок. Второй: сколько ходов, то есть дополнительных вопросов и реплик в чате с продуктом, разрешить внутри одной попытки.
Повторы. Vals во втором VLAIR гонял каждый вопрос не менее трёх раз. Thomson Reuters среди своих принципов предлагает задавать один вопрос по двадцать раз, чтобы увидеть воспроизводимость. Это разумно потому, что показывает стабильность как самостоятельную метрику продукта: доля задач, где повторные прогоны дают один и тот же вердикт по критическим критериям. Для того, кто выбирает сервис на постоянное использование, это свойство важнее лишнего процента точности по сравнению с похожим сервисом. При этом сам замер вследствие этого заметно удорожается.
Ходы. Здесь нормального ответа ни у кого пока нет. Практически все живые бенчмарки одноходовые: задача подаётся одним сообщением, ответ берётся первый. Legalbenchmarks прямо признаёт это ограничением и пишет, что многоходовые сценарии, длинные дела и итеративная доработка не тестируются — а это ближе к тому, как юристы реально пользуются инструментами. У Harvey в LAB агент работает долго и многошагово, но не переписывается с человеком: поручение партнёра нарочно недоспецифицировано, и спросить не у кого.
Проблематика здесь в том, что диалог ломает сравнимость сервисов. Если один продукт переспрашивает, а другой нет, они работают с разным объёмом информации, и сравнивать их результаты некорректно. Качество навыка задавать уточняющие вопросы у разных сервисов может быть принципиально разным: где-то хорошо настроены классификаторы, и выдаётся минимально ценный ответ, а какие-то сервисы сетапят выуживание из пользователя дополнительной информации, так как не рискуют давать неполный ответ. С точки зрения пользователей правильного рецепта нет, это абсолютная вкусовщина, решения здесь чисто продуктовые и ориентирующиеся на ваших родных пользователей. Кроме того, усложняется и становится дороже сам бенчмаркинг: кто-то должен отвечать на уточняющие вопросы, у него должен быть чёткий бриф, как это делать.
При этом значительная часть сервисов как раз и построена на том, что продукт ведёт пользователя: уточняет тип запроса, просит догрузить документ, восполняет пробелы в рассказе пользователя о задаче. Мерить их одноходовым замером означает не смочь замерить функциональность сервиса вообще. Я с этим столкнулась даже в своём беби-бенчмаркинге: сервис АйЮрист добирал информацию, не выдавая на первом ходе почти никакого ответа едва ли не в трети случаев.
Какие есть способы смягчать этот угол? Идеального нет, у каждого найдутся свои минусы:
- В каждый промпт по задаче вставлять указание ориентироваться только на предоставленную информацию, но при необходимости задавать дополнительные вопросы. Но такой способ не проверяет, умеет ли в целом сервис распознавать критичные недосказанности без подсказки.
- Засчитывать уточнение как валидную форму ответа. Рубрика прямо описывает, что при недостатке данных система либо задаёт уточняющий вопрос, либо явно перечисляет принятые допущения, а проваливается молчаливое додумывание. Но это должны быть точечные аспекты кейса, а не полный отказ отвечать без дополнительной информации.
- Два прогона одной задачи — с минималистичным контекстом и с полным. Один и тот же кейс подаётся дважды: сначала так, как спросил бы неподготовленный пользователь, потом с выданным сразу контекстом. Дельта между двумя прогонами и есть ранее упомянутая нагрузка на пользователя — но здесь стоит подумать, обоснованно ли сводить оценку нагрузки на пользователя только к этому аспекту.
- Отвечающий оператор с жёстким брифом. Автор задачи вместе с ней пишет досье: какие дополнительные факты существуют и были бы раскрыты, если спросить. На уточняющие вопросы отвечает жёстко ограниченный досье скрипт с лимитом ходов, на всё за его пределами — «не знаю».
3.7. Отчёты и лидерборды
Выбирая принцип формирования лидерборда, нужно сформулировать точные вопросы, на которые этот лидерборд должен отвечать. Поскольку вопросы можно ставить практически любые, палитра вариантов в дизайне отчётов огромна. В западных бенчмарках встречаются такие варианты:
- Полный зачёт (all-pass). Задача засчитана, только если пройдена каждая рубрика. Прошло всё — 100%, не прошёл один пункт — 0%. Так считает Harvey в LAB, Vals в Legal Research Bench, так устроена метрика надёжности у Legalbenchmarks.
- Доля пройденных рубрик. У Vals это weighted-балл рядом с основным, у Artificial Analysis в их прогоне LAB — criterion pass rate.
- Зачёт по критичным рубрикам. Тест провален, если отсутствует хотя бы одна деталь, которую тестировщик заранее пометил критической. Так описывала свою практику команда Thomson Reuters.
- Взвешенный процент рабочего продукта. В BigLaw Bench балл считался как сумма положительных и отрицательных очков, делённая на максимум доступных положительных, и отдельно считался балл за источники. Здесь формулы полезности можно выводить очень разные.
- Несколько содержательных критериев с разными весами. Во втором VLAIR итоговый балл складывался из точности (50%), авторитетности источников (40%) и пригодности ответа к отправке как есть (10%).
- Полезность отдельной осью. У Legalbenchmarks ясность, длина и структура оцениваются по шкале от 1 до 3 и отчитываются отдельно от надёжности, принципиально не сплавляясь в один балл.
Выбирать один разрез опасно. Полный зачёт отвечает покупателю: можно ли это отдать клиенту без переделки. Доля критериев отвечает разработчику: что именно сломано. Полезность отвечает пользователю: придётся ли причёсывать результат руками. Ответы не заменяют друг друга, и любое одно число из трёх вводит в заблуждение вашу аудиторию. Поэтому кажется взвешенной такая сборка:
Полный зачёт (all-pass) считается по критическим критериям + доля пройденных — по всем + полезность на отдельной оси. И показывать их надо все три сразу, рядом, а не выбирать главную.
И, кроме того, реально полезный бенчмарк должен показывать любую из этих метрик не одним числом, а в разрезах, которые мы обсудили выше: по сценариям, по отраслевым тегам, по источникам сложности. Ни один сводный балл не позволит принять взвешенное решение конкретному пользователю по его уникальному запросу и ожиданиям от нейросетей.
4. Протокол и публикация
Последний методический блок организационного характера: что нужно делать вокруг замера. На этом блоке фасилитатор бенчмарка даёт гарантии прозрачности замера и, собственно, строит свою репутацию.
4.1. До прогона
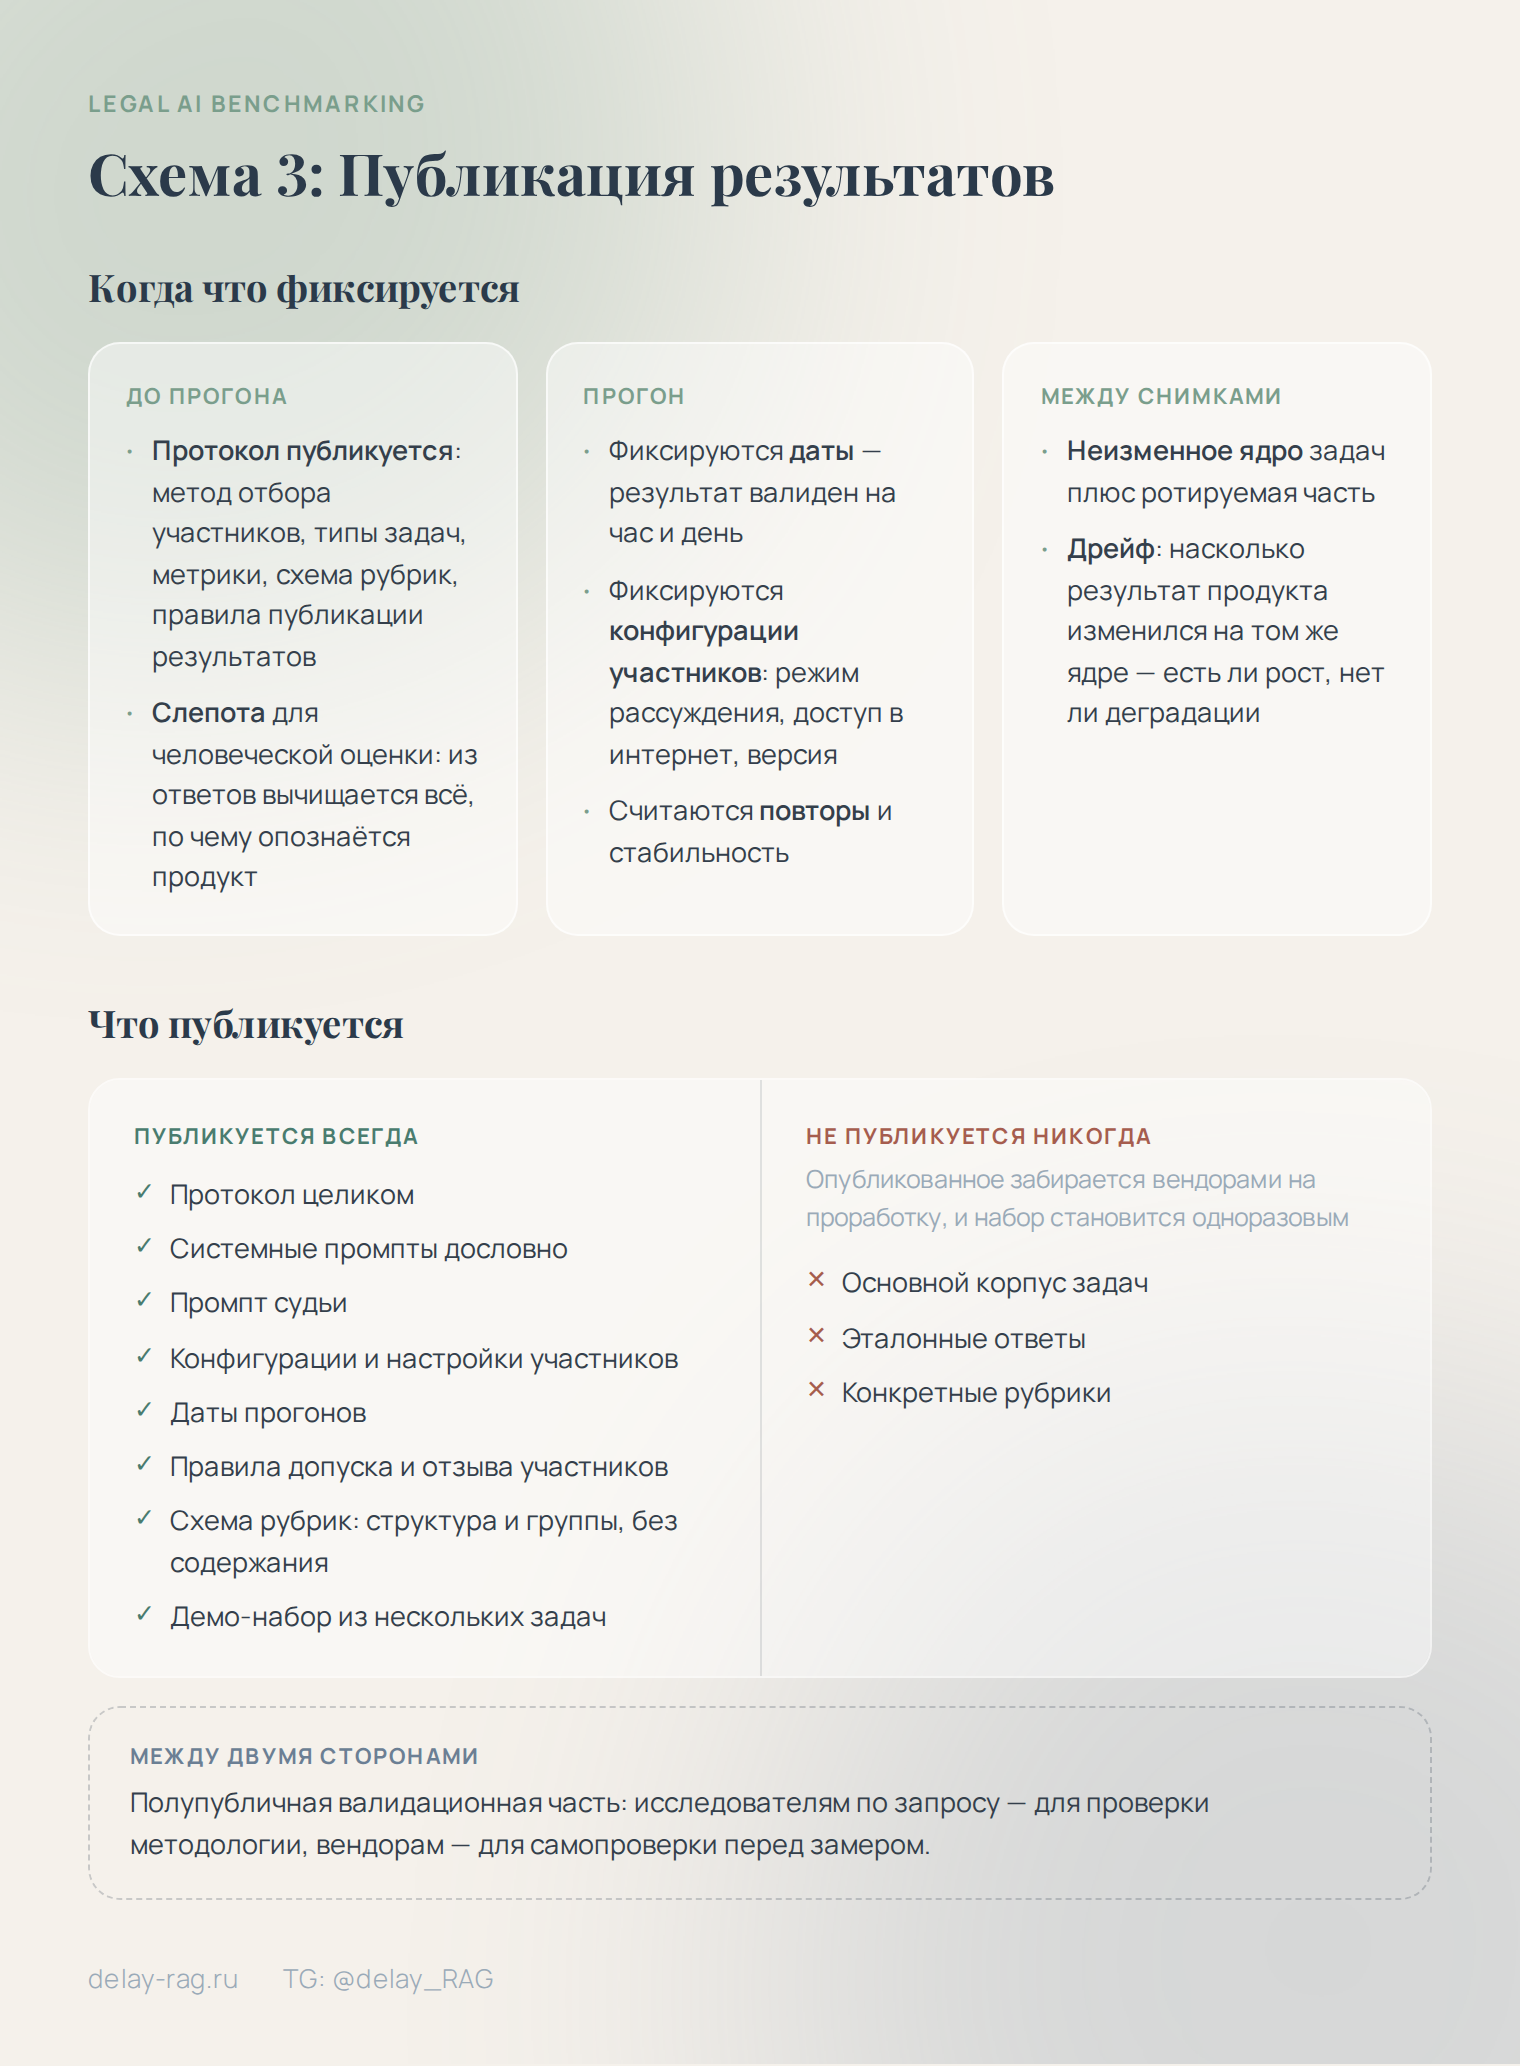
Публикация протокола. Метод отбора участников, данные о типах задач, метрики, рубрики, правила публикации результатов фиксируются публично до прогона. Защищает от соблазна переформулировать критерии, когда результат не понравился.
Обеспечение слепого замера для human eval. Оценщики не должны знать и даже догадываться, чей ответ они смотрят. Во втором VLAIR ради этого из ответов вычищали ссылки на проприетарные источники, по которым опознаётся продукт.
4.2. Публиковать ли задачи?
С одной стороны, открытый датасет вызывает доверие, но он одноразовый: все опубликованные задачи моментально забираются вендорами для проработки. Закрытый живёт долго и позволяет делать наиболее полезный вариант бенчмаркинга — периодический, но его нельзя проверить снаружи.
В западных бенчмарках сформировался взвешенный подход к решению этого аспекта:
- Публикуется всегда: протокол целиком; системные промпты дословно; промпт судьи; конфигурации и настройки участников (например, используется ли режим рассуждения или поиск в Интернете); даты прогонов; правила допуска и отзыва участников; схема рубрик — структура и группы критериев, но не их содержание; демо-набор из нескольких задач.
- Не публикуется никогда: основной корпус задач, эталоны, конкретные критерии.
- Промежуточное: валидационная полупубличная часть, предоставляемая исследователям по запросу для проверки методологии, вендорам для самопроверки.
4.3. Снимок или измерение
Любой опубликованный результат — это снимок на конкретную точку во времени. Модели меняются, продукты меняются, судьи меняются: иногда буквально на следующий день после замера. Хороший бенчмарк не бывает разовым: сервисы развиваются непрерывно, лидерборд, обновляемый раз в год, бесполезен. Legalbenchmarks перезапускается ежемесячно, Vals обновляет замер по мере выхода моделей.
Регулярный бенчмаркинг учитывает продуктовую волатильность, а также даёт отдельную метрику — дрейф между снимками: насколько изменился результат продукта на неизменном ядре задач. Это хороший индикатор для закупочных решений: есть ли у сервиса рост, нет ли деградации. Это важно понимать, если хочется подписаться с каким-то сервисом надолго.
5. Вы уже поняли, почему бенчмаркинг — это дорого?
Вообще нужно оговориться, что дорого не только в юридическом домене: дорого во всех сферах «настоящей работы», где совпали три условия:
- нет проверяемого безусловно правильного ответа;
- и задачу, и её оценку может сделать только эксперт;
- результат решения задачи — развёрнутый и наполненный субъективщиной и отраслевой спецификой текст.
Соседние отрасли дают ценовые ориентиры, которые полезно держать в голове:
- Медицина. В HealthBench рубрики к пяти тысячам диалогов писали 262 врача, практиковавших в 60 странах; получилось около 48,5 тысяч уникальных критериев.
- Разные профессии. В GDPval 1 320 задач из 44 профессий; авторы — практики со средним стажем 14 лет, одна задача требует в среднем семи часов работы эксперта, и каждая проходит порядка пяти независимых экспертных проверок.
- Право. В JudgmentBench на разметку (то есть не составление с нуля) 30 задач ушло 242 часа адвокатского времени, что авторы оценивают примерно в 242 тысячи долларов.
Для российской правовой действительности возникают ещё и расходы на поддержание бенчмарка в актуальном состоянии. Как обсудили выше, для нашего права есть нюансы по работе с источниками и их действием во времени. Эталонные ответы могут быстро протухать, сами вопросы и задачи не покрывать новое критически важное регулирование или практику. Что ещё можно накинуть:
- экспертов, готовых писать задачи и размечать, не так уж много, а делать это забесплатно — единицы, энтузиасты или лояльные фасилитатору;
- заказчика, готового платить за независимый замер, не существует в природе: об этом будет следующая часть;
- наш рынок — это рынок множества внешне малоразличимых продуктов. Для регулярного замера десятков кандидатов с достаточной различительной способностью, чтобы от бенчмарка был толк, нужно выстраивать буквально корпорацию с неглупыми людьми на зарплате.
6. Поле вариантов
Всё сказанное я собрала в конструктор. Предлагаю поиграться и пройти по этой схеме сверху вниз. По моей задумке вы должны увидеть, что каждое решение требует организации и постоянства. Предрегистрация бессмысленна без того, кто её принимает. Защищенный сет задач бессмысленен без того, кто его хранит и кому верят, что он его не показывал вендорам. Правило «результат не отзывается после прогона» вообще не существует вне договора, а договор нужен с кем-то.
То есть вся эта длинная методическая часть подводит нас к институциональному и неудобному вопросу: у кого одновременно есть деньги, доступ к продуктам и незаинтересованность в результате. Это такой байт на ожидание следующей части, а пока предлагаю потыкать!
И напоследок: что меняется, если бенчмарк внутренний
Бонус для дочитавших: подсказки вендорам!
Большая часть из того, что написано выше — про независимые публичные замеры. Внутренние устроены иначе:
- Другая цель. Не выстраивание рейтинга, а определение собственных зон роста. Значит, важнее всего — видеть долю выполненных рубрик по группам навыков: так понятно, что именно чинить или развивать.
- Проще с задачами. Их не надо выдумывать, их можно брать из пользовательских данных. Это самый дешёвый и при этом самый релевантный источник задач, который только может быть.
- Проще с LLM-судьями. Можно меньше заморачиваться, потому что вендору не нужно, чтобы его калибровке верил рынок.
- Другая регулярность — под свои релизные планы.
Но некоторые проблемы, например, протухание эталона и неактуальные задачи, остаются. Нужны версионирование, дата валидности эталона и регламент ревизии при изменении регулирования.
А ещё важно так настроить внутреннюю культуру и всё-таки следить за методологией, чтобы бенчмарк отражал реальность. Внутренний бенчмарк, который никто не видит, легко превращается в инструмент самоуспокоения. Кажется, что хороший внутренний бенчмарк — это тот, результатами которого вы недовольны (при том, что постоянно видите рост).